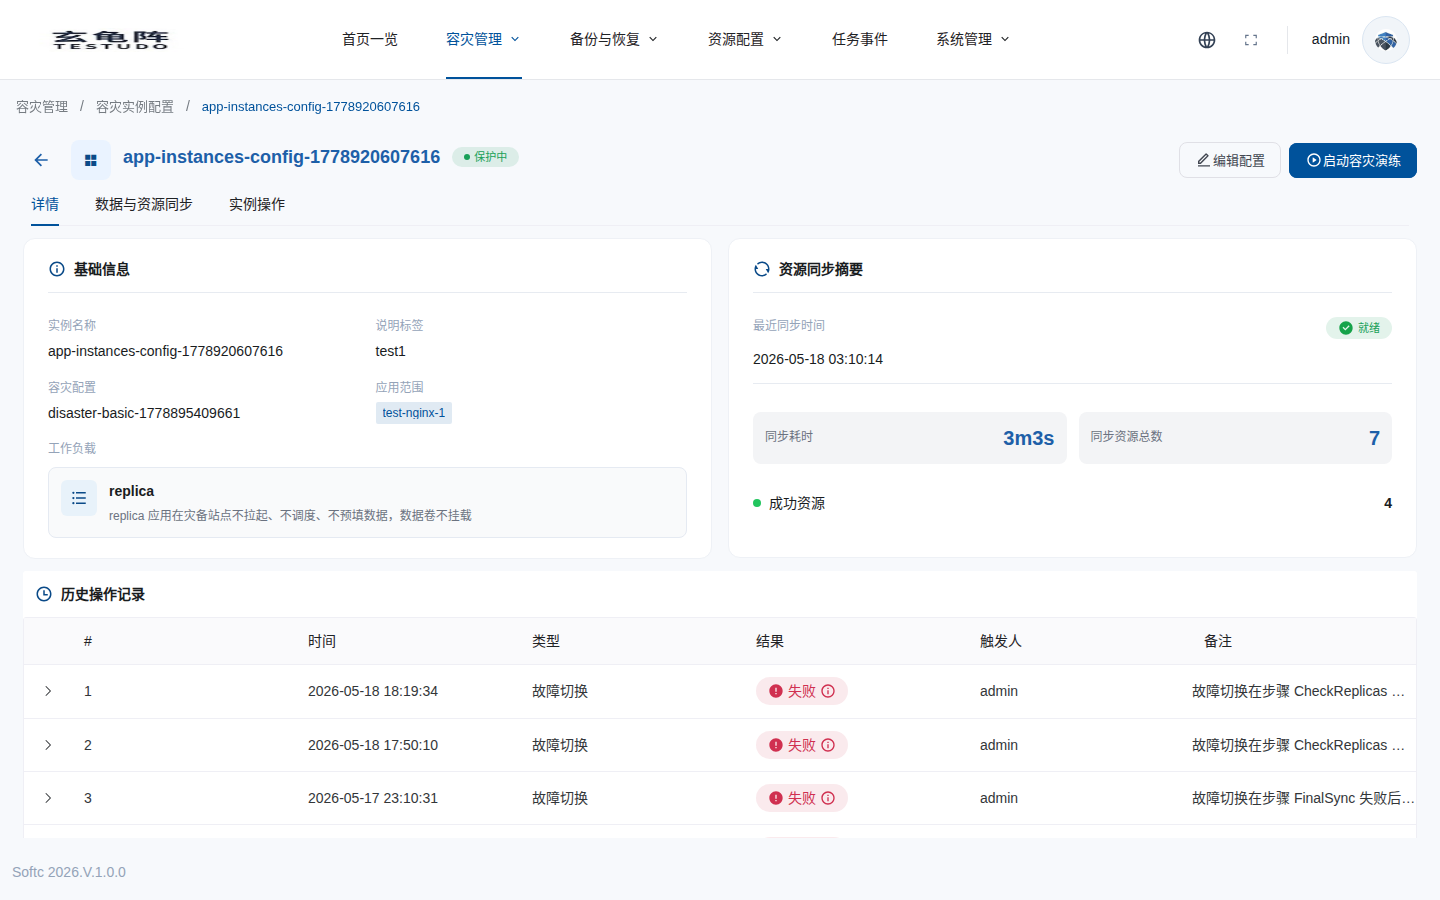
执行实例级故障切换 Failover
Failover 是把一个受保护实例从源集群切换到目标集群的核心操作。它会创建 DisasterOperation,由 operator 按步骤执行。
Testudo V2 当前采用 Pilot Light(长明火)模式:备集群持续保留 standby 资源,工作负载默认保持 replicas=0,切换时再拉起目标侧工作负载。完整流程见 容灾切换流程。
本页使用真实控制台操作的实例 docs-walkthrough-20260511。该实例先进入 Protected,随后执行 Failover。第一次按“执行最后一次同步”触发时,FinalSync 超过前端固定的 3 分钟超时,Operator 自动补偿后恢复为 Protected;第二次不执行最终同步的快速切换成功进入 Active;最后执行“反向保护”回到 Protected。
切换前检查
- 实例状态为
Protected。 - 最近一次 DataSync 和 ResourceSync 成功。
- 目标集群 standby 资源存在。
- 目标集群业务依赖、镜像、Secret、网络和入口已准备。
- 团队已确认流量切换窗口。
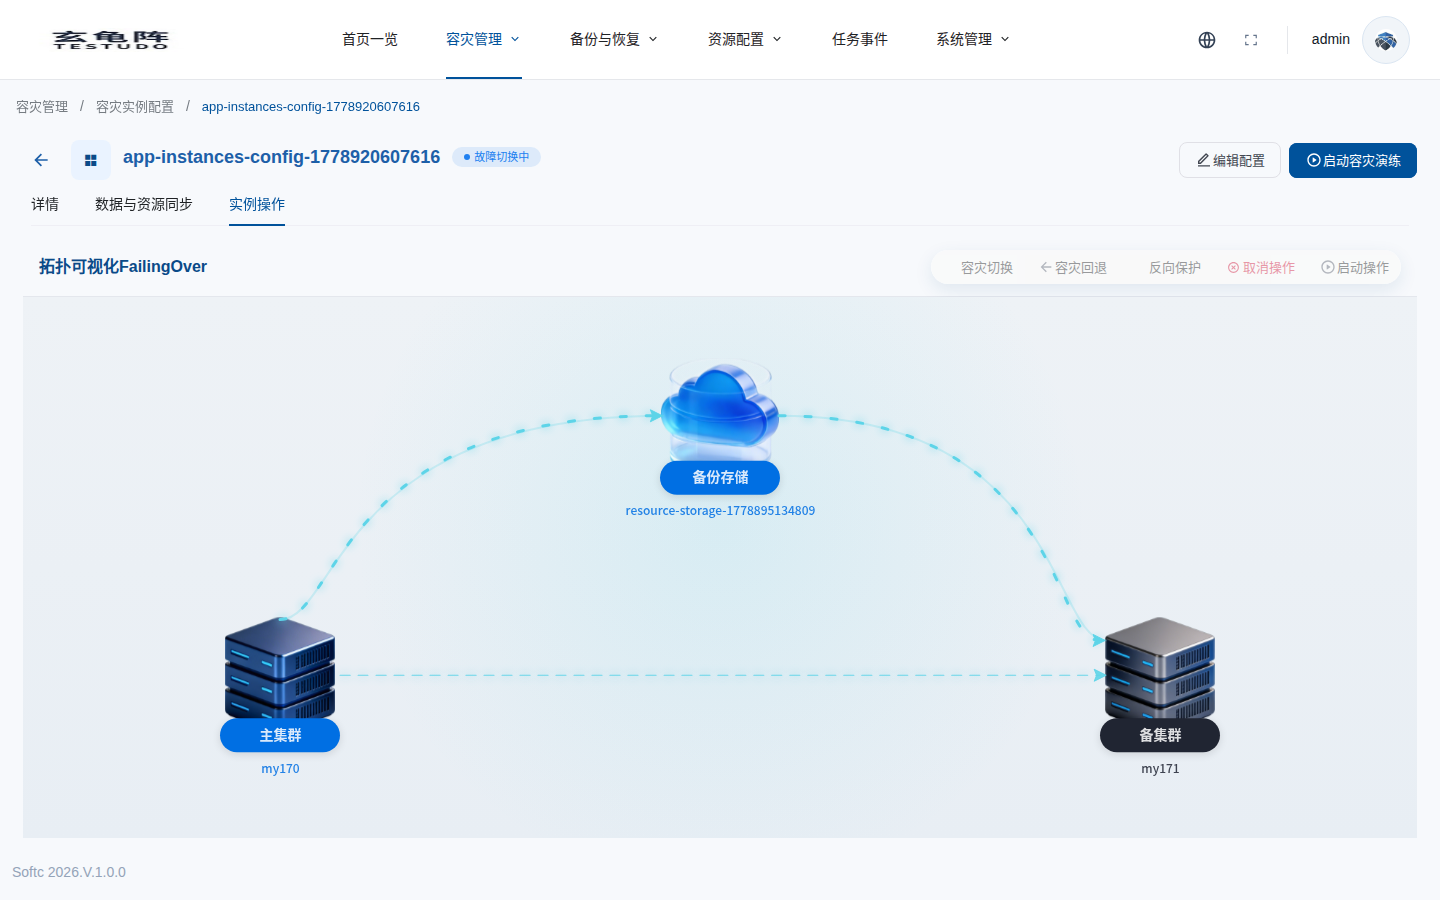
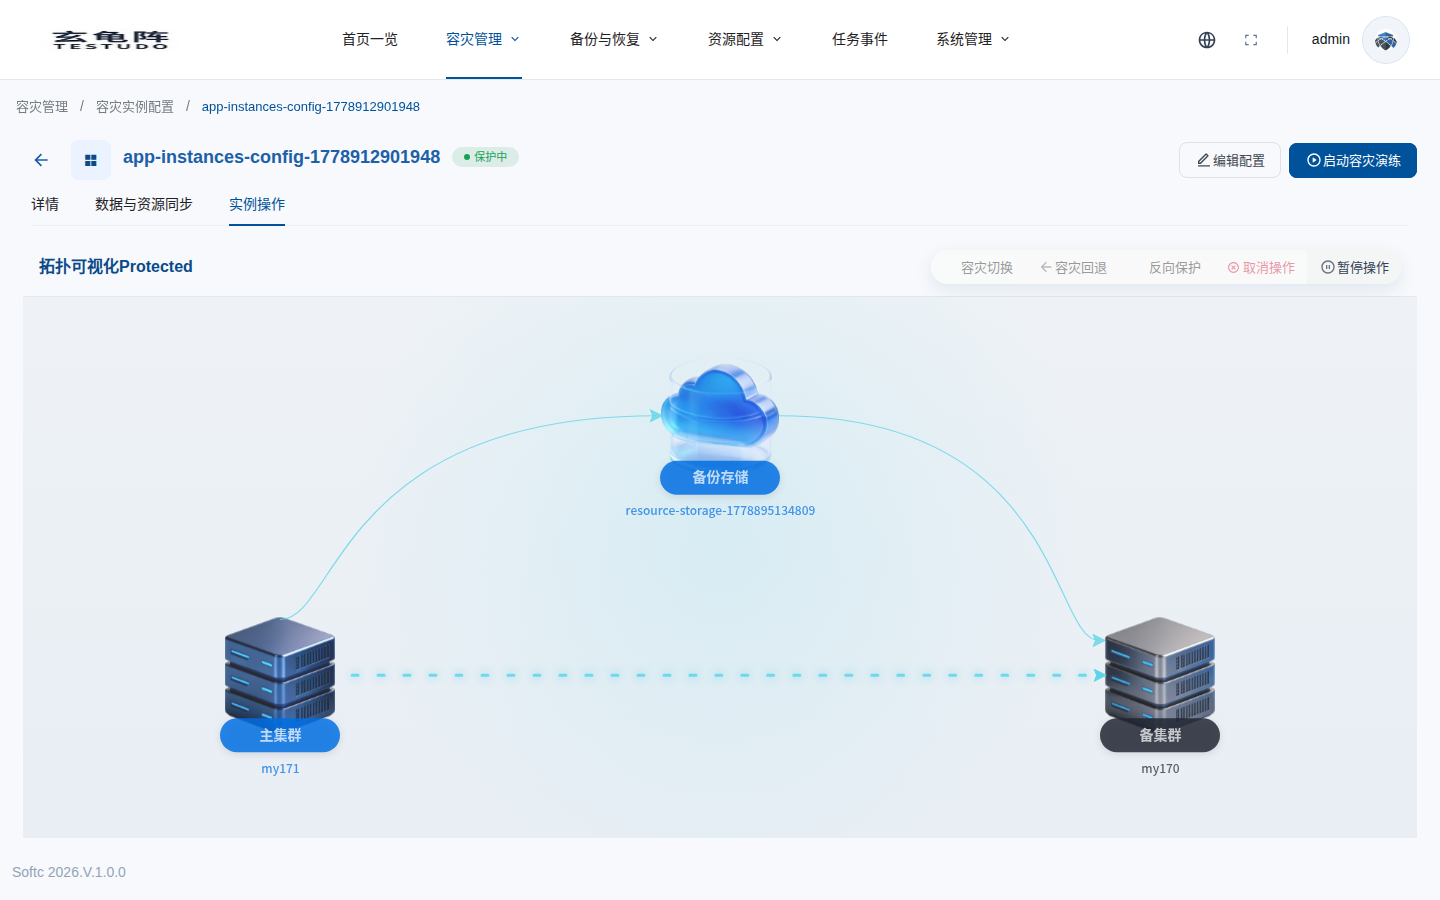
进入实例详情页的 实例操作 标签。拓扑图展示当前主集群、备集群和备份存储。
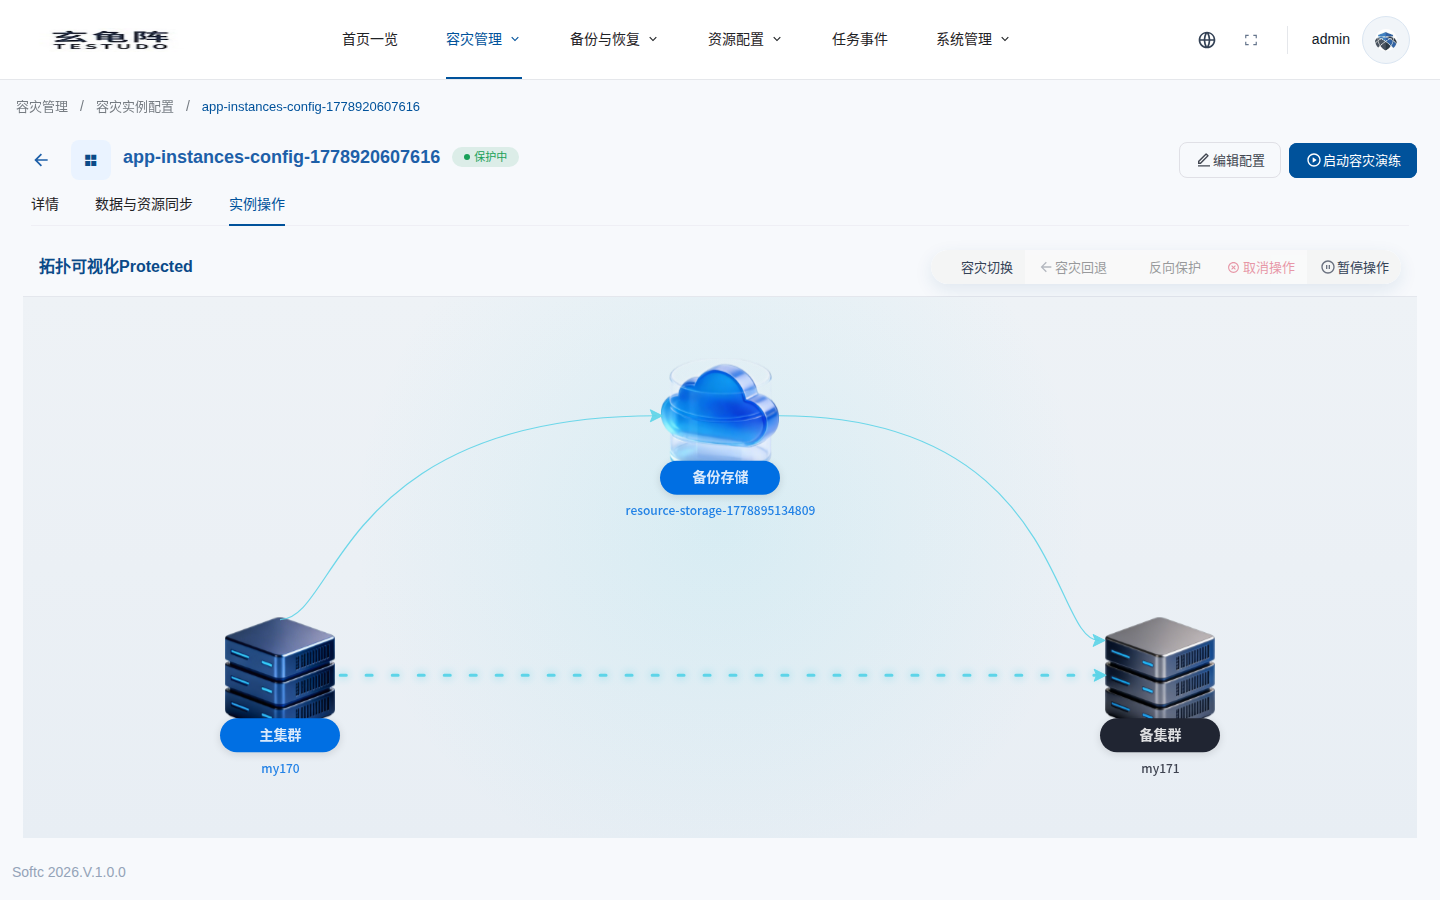
模块说明:
- 主集群:当前承载业务的 primary cluster。
- 备集群:当前 standby cluster。
- 备份存储:DataSync/ResourceSync 使用的存储仓库。
- 容灾切换:
Protected或Paused状态可点击,创建operationType=failover的DisasterOperation。 - 容灾回退:实例进入
Active后可用,创建operationType=undo。 - 反向保护:实例进入
Active后可用,创建operationType=reprotect,在当前新主方向重新建立保护。 - 暂停/启动操作:对 DataSync 和 ResourceSync 执行 pause/resume。
执行步骤
Failover 通常包含:
PreCheck:检查实例、集群、仓库和同步状态。PauseSchedules:暂停周期同步,避免并发变更。FinalSync:执行最后一次数据和资源同步。ScaleDownSource:按策略缩容源端。ScaleUpTarget:恢复目标侧副本数。CheckReplicas:检查目标侧工作负载状态。SwitchRoles:切换实例角色关系。
实际步骤来自 DisasterOperation.status.steps。本次接口返回的步骤顺序为:
PreCheck -> PauseSchedules -> FinalSync -> ScaleDownSource -> ScaleUpTarget -> CheckReplicas -> SwitchRoles
确认切换参数
点击 容灾切换 后会出现确认框。
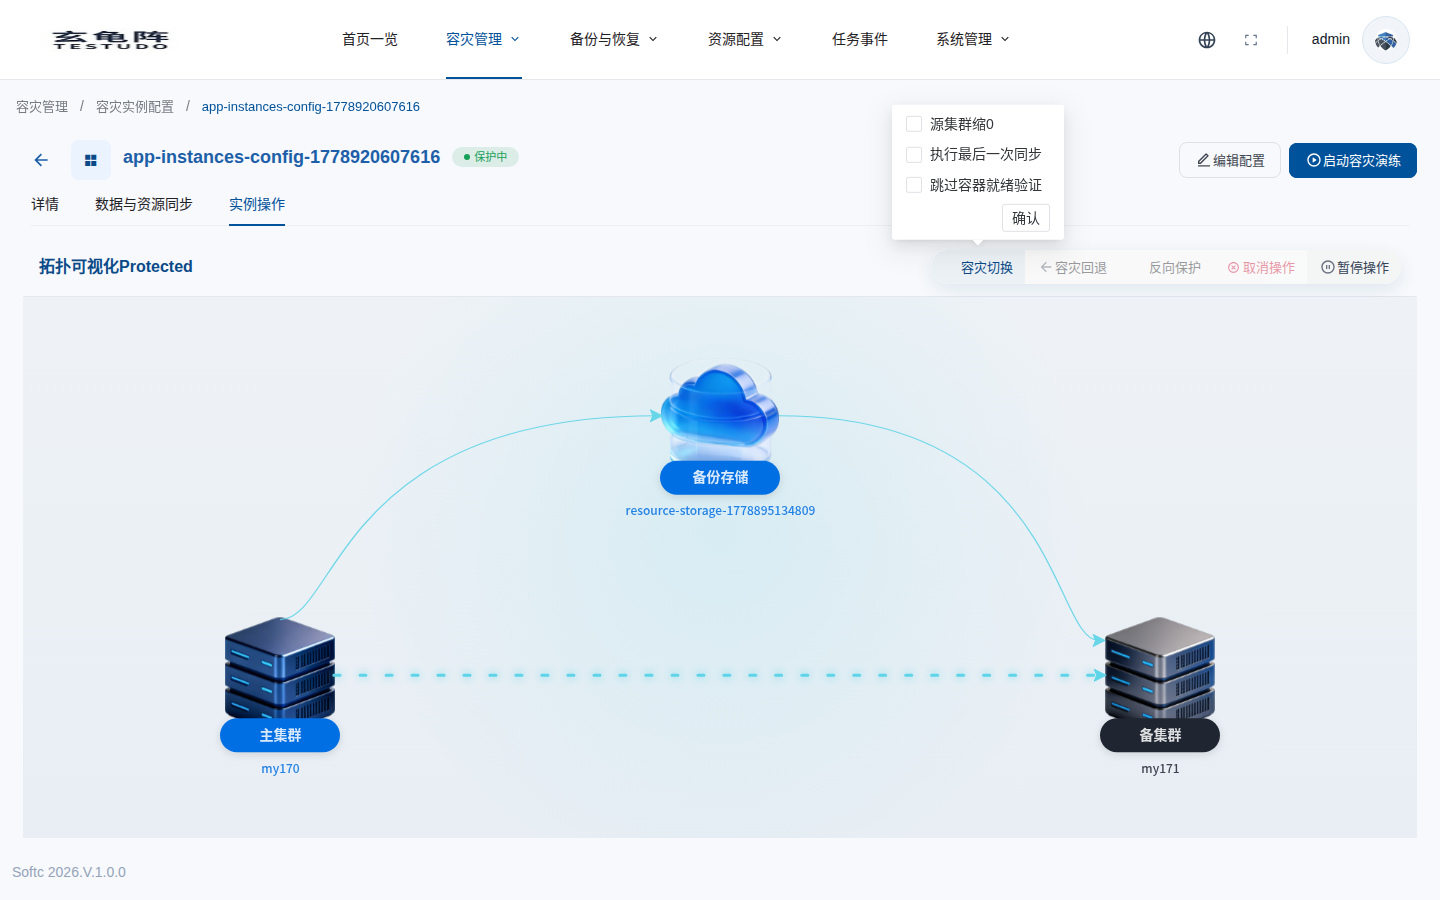
确认框有三个参数:
| UI 选项 | 写入接口字段 | 说明 |
|---|---|---|
| 源集群缩0 | config.skipScaleDownSource | 勾选后,前端传 false,表示执行源端缩容;不勾选时传 true,表示跳过源端缩容。 |
| 执行最后一次同步 | config.skipFinalSync | 勾选后,前端传 false,表示执行最终同步;不勾选时传 true,表示跳过最终同步。 |
| 跳过容器就绪验证 | config.skipPodReadyCheck | 当前前端代码同样做了取反,文档以接口字段为准;实际请求结果可在 DisasterOperation.spec.skipPodReadyCheck 中确认。 |
这三个字段的接口由以下代码链路确认:
- 前端:
InstanceOperation.vue调用POST /instances/:name/actions。 - Server:读取
config.skipFinalSync、config.skipScaleDownSource、config.skipPodReadyCheck并创建DisasterOperation。 - Operator:按
DisasterOperation.spec控制是否执行 FinalSync、ScaleDownSource 和 Pod ready 检查。
提交切换
示例中第一次勾选 源集群缩0 和 执行最后一次同步。
提交后实例进入 故障切换中,操作按钮被禁用,拓扑图展示正在执行。
API
POST /apis/disasterinstances.testudo.softcdata.com/v1/instances/:name/actions
{
  "operation": "failover",
  "config": {
    "timeoutMinutes": 3,
    "skipScaleDownSource": false,
    "skipFinalSync": false,
    "skipPodReadyCheck": true
  }
}
成功响应是异步受理,不代表切换已经完成:
{
  "data": {
    "operationID": "failover-docs-walkthrough-20260511-1778492672918796991",
    "status": "Processing"
  }
}
观察操作
kubectl -n disaster-system get disasteroperation -l testudo.softcdata.com/instance=docs-walkthrough-20260511
kubectl -n disaster-system describe disasteroperation failover-docs-walkthrough-20260511-1778492672918796991
也可以看详情接口:
GET /apis/disasterinstances.testudo.softcdata.com/v1/instances/:name/operations/:operationName
超时补偿示例
第一次切换执行最终同步时,FinalSync 超过 3 分钟超时。Operator 将该次 DisasterOperation 标记为 Failed,并自动补偿恢复实例为 Protected。
自动补偿的完整分流逻辑见 容灾切换失败自动补偿机制。
接口返回的关键字段:
{
  "state": "Failed",
  "reason": "StepFailed",
  "currentStep": "FinalSync",
  "message": "故障切换在步骤 FinalSync 失败后已自动补偿,实例已恢复为 Protected",
  "autoCancel": {
    "triggered": true,
    "status": "Succeeded",
    "triggerStep": "FinalSync"
  }
}
这类情况通常说明最终同步时间超过当前操作超时配置。处理方式:
- 检查 DataSync/ResourceSync、AppBackup/AppRestore、Velero Backup/Restore 事件。
- 对生产切换窗口,按实际数据量配置更合理的操作超时。
- 如果业务允许,可跳过最终同步,使用最近一次成功同步点执行快速切换。
快速切换成功
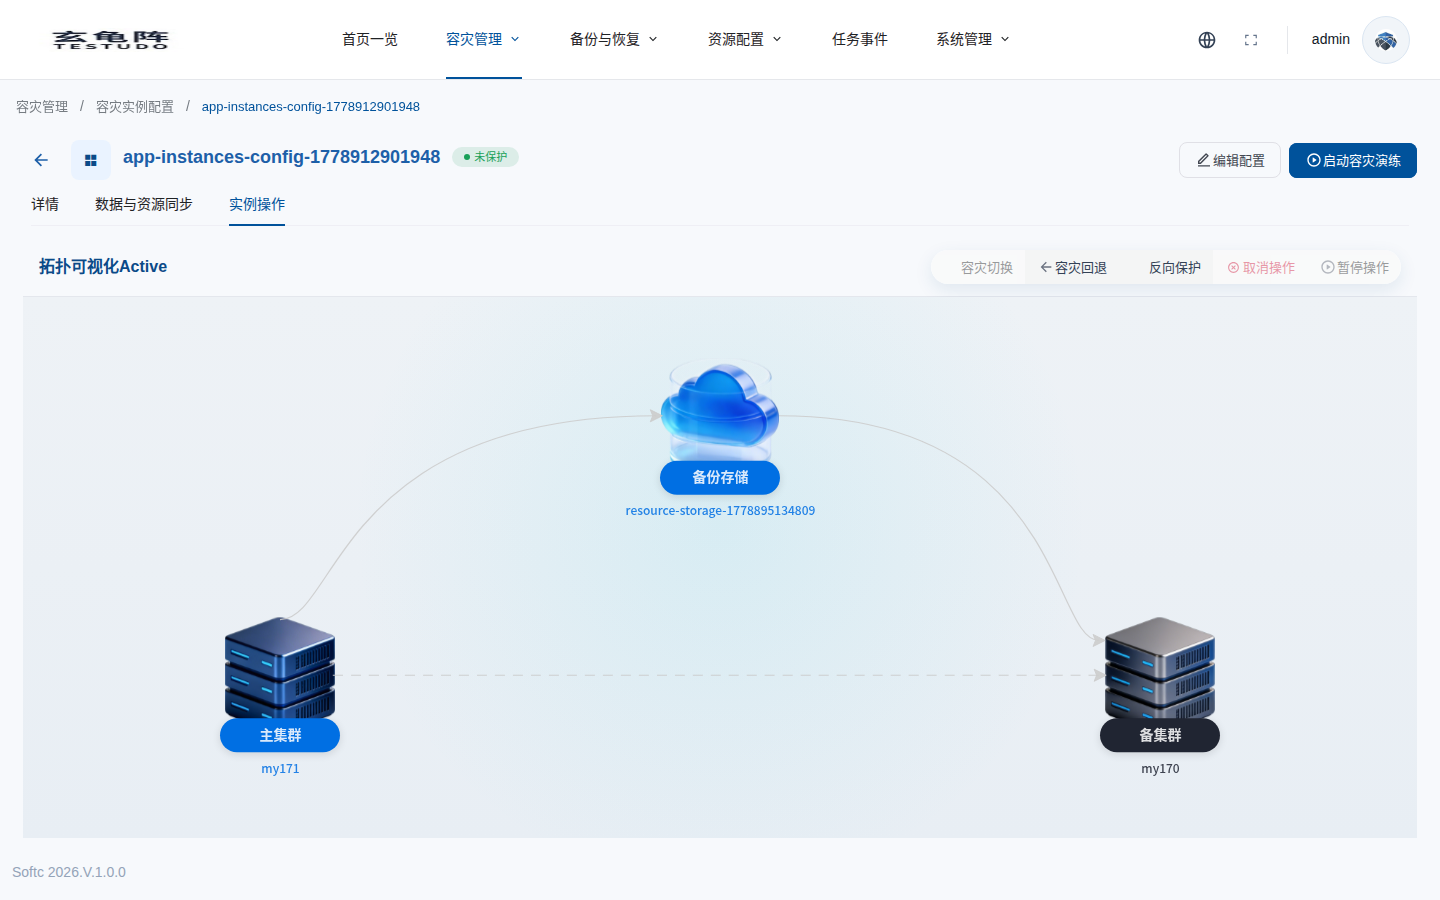
第二次切换不勾选 源集群缩0 和 执行最后一次同步,前端请求会跳过源端缩容和最终同步。该次操作快速完成,实例进入 Active,界面展示为 未保护,主备角色变为:
{
  "fsmState": "Active",
  "primaryCluster": "cluster-ip171-1774332463",
  "secondaryCluster": "ip170-test-001",
  "availableOperations": ["reprotect", "undo"]
}
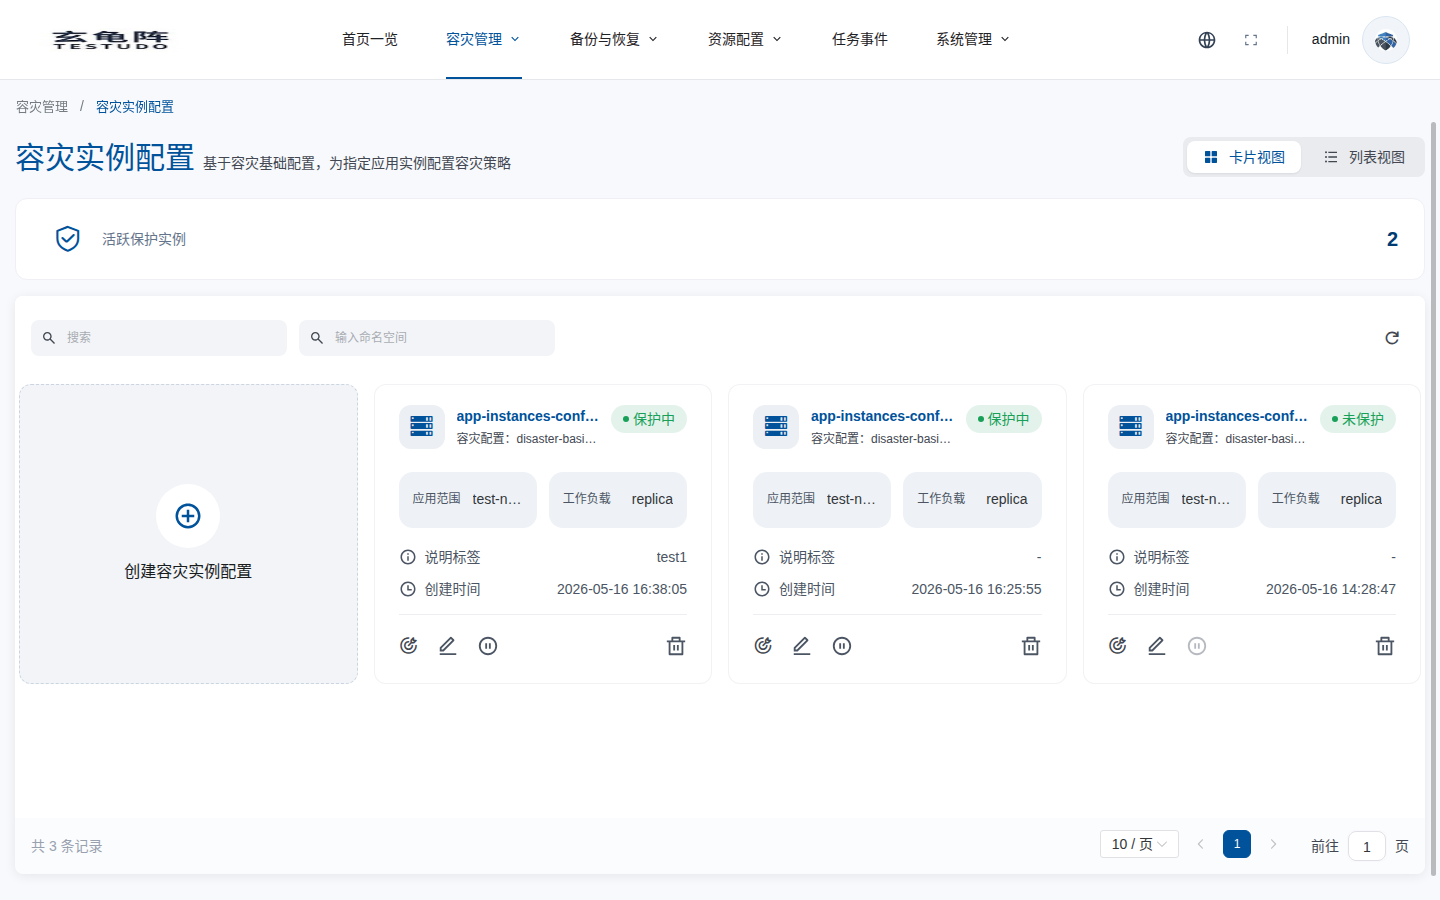
列表页也会显示该实例为 未保护,操作列从“暂停”变为“启用”。
切换后验证
kubectl --context <target-cluster> -n dr-pvc-src-170 get deploy,sts,pod,svc,pvc
kubectl --context <source-cluster> -n dr-pvc-src-170 get deploy,sts
确认目标侧应用可用后,再进行 DNS、网关或外部流量切换。Testudo 不直接替代全局流量管理。
反向保护
Failover 成功后,详情页可执行 反向保护,在当前新主集群到原主集群的方向重新建立保护。
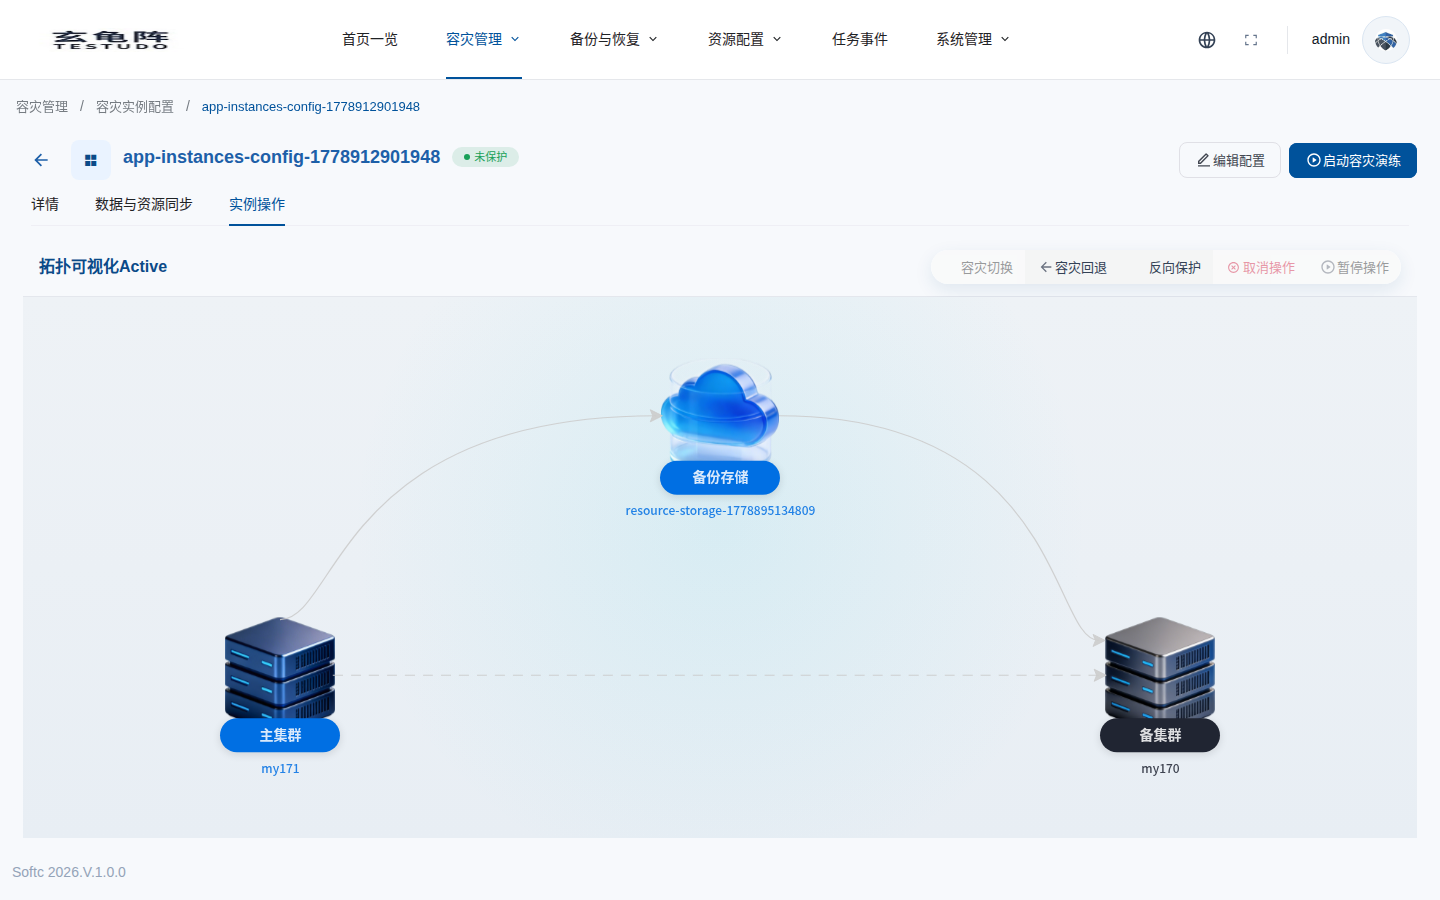
示例中反向保护成功后,实例回到 Protected,但主备方向已经变为:
{
  "fsmState": "Protected",
  "primaryCluster": "cluster-ip171-1774332463",
  "secondaryCluster": "ip170-test-001"
}
历史记录会保留成功切换、失败补偿和反向保护操作,便于审计。