创建容灾实例:命名空间、标签和 Standby 模式
DisasterInstance 是应用容灾保护的核心对象。它指定保护哪些命名空间和资源,以及目标集群如何保持 standby 状态。
本页按真实控制台流程说明字段含义。示例值如下;截图中如果出现 disaster-basic-...、test-nginx-... 这类当前演示环境名称,按同样位置选择你的业务配置和命名空间即可。
| 项目 | 示例值 |
|---|---|
| 容灾实例 | docs-walkthrough-20260511 |
| 容灾基础配置 | dc01 |
| 源集群 | ip170-test-001 |
| 目标集群 | cluster-ip171-1774332463 |
| 保护命名空间 | dr-pvc-src-170 |
| 工作负载模式 | replica |
进入实例列表
进入 容灾管理 / 实例配置。
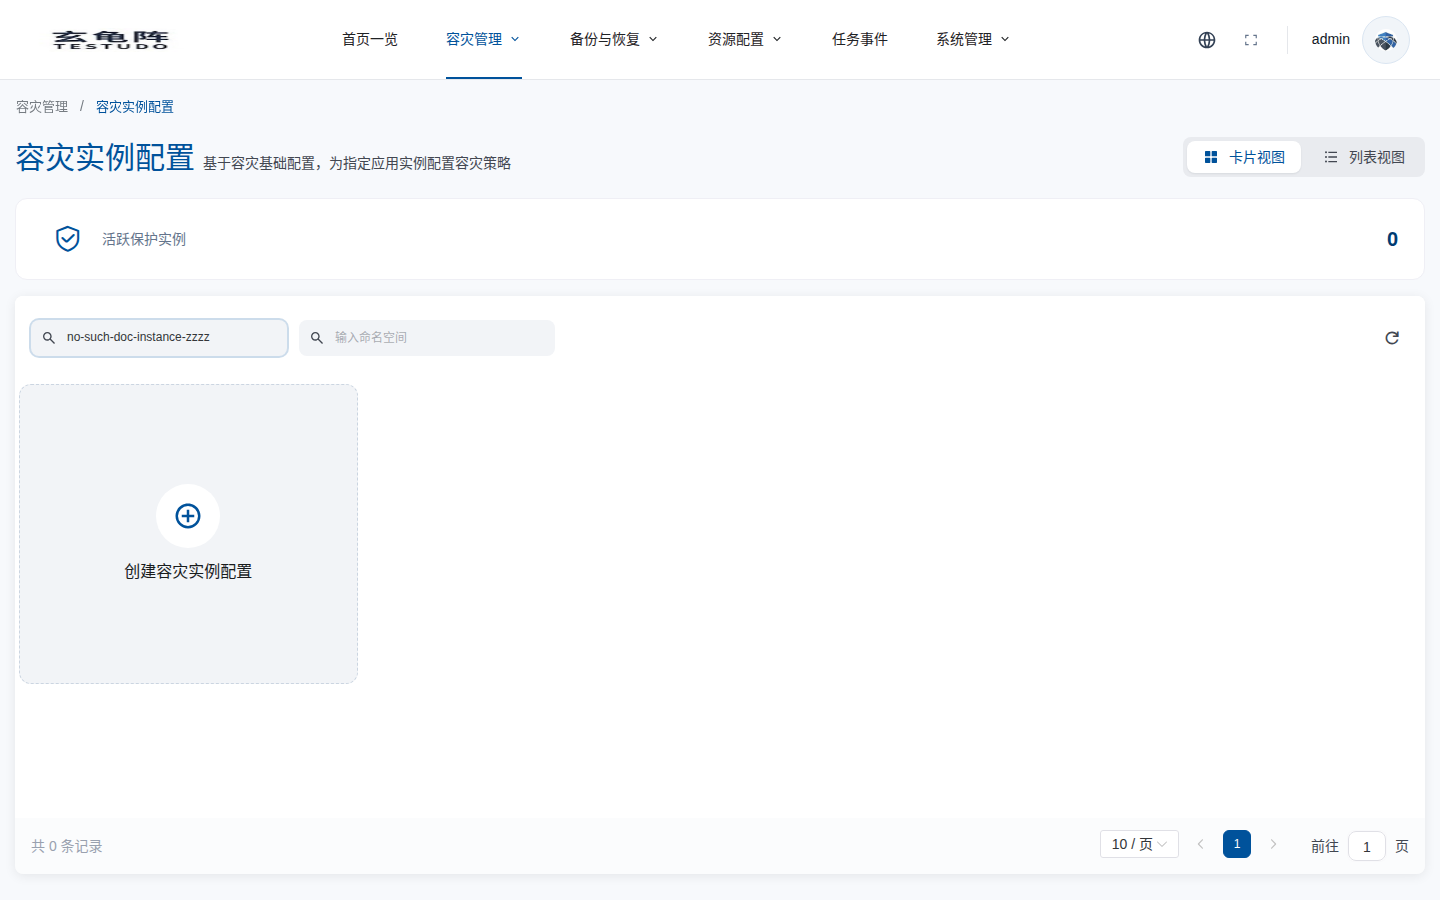
列表页包含以下模块:
- 名称:实例名是可点击链接,点击后进入实例详情页。
- 说明标签:来自创建表单里的说明文本,用来辅助识别保护对象。
- 容灾配置:引用的
DisasterConfig,决定源集群、目标集群、仓库和默认同步策略。 - 应用范围:当前实例保护的命名空间集合。
- 工作负载:当前前端只提供
replica,目标侧 standby 资源会按策略保持不对外服务。 - 状态:来自
status.fsmState。Protected在界面展示为 保护中。 - 操作:列表页提供暂停/启用,以及更多操作入口;切换、回退、反向保护在详情页的 实例操作 中执行。
填写基础信息
点击 创建容灾实例配置,先填写名称、说明标签,并选择容灾配置。
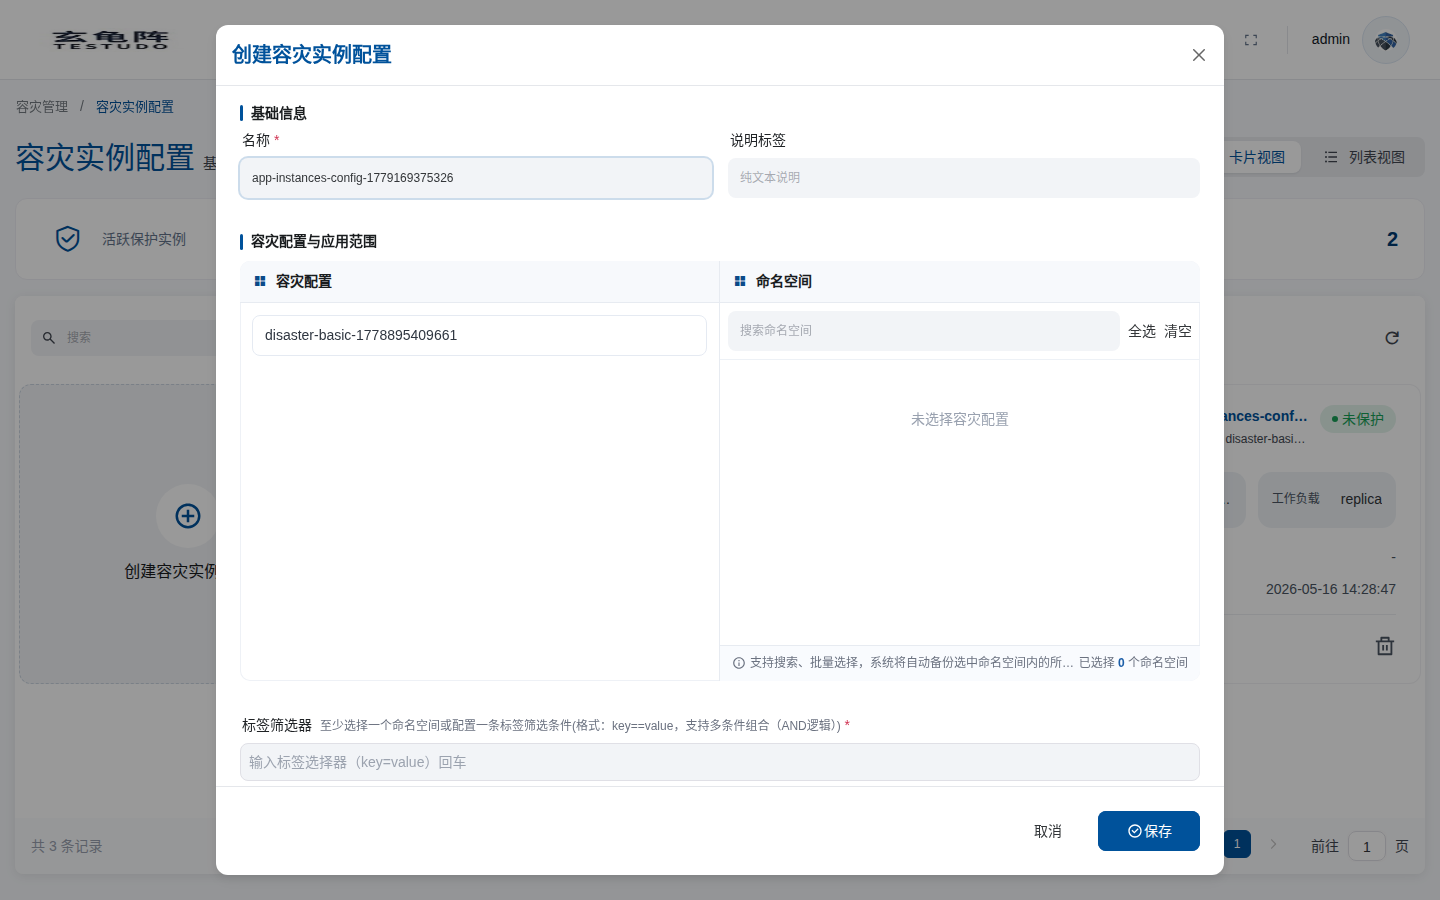
创建弹窗分为四块:
- 基础信息:实例名和说明标签。实例名写入
DisasterInstance.metadata.name。 - 容灾配置:选择 Ready 状态的
DisasterConfig。选择dc01后,前端会按该配置加载源集群可保护命名空间。 - 应用范围:选择命名空间、标签筛选器和工作负载类型。
- 高级选项:配置 StorageClass 映射、Resource Policies、资源定制化修改和批量修改。
选择应用范围
命名空间列表来自源集群的 workloadNamespaceStats,不是所有 namespace 都会出现。创建容灾实例时,控制台只会展示包含运行中 Deployment 或 StatefulSet 应用的命名空间:
- Deployment:
readyReplicas > 0或availableReplicas > 0。 - StatefulSet:
readyReplicas > 0。
也就是说,当前容灾实例的应用级保护对象是 Deployment 和 StatefulSet。Service、Ingress、ConfigMap、Secret、PVC 等会作为应用配套资源随同步和恢复处理;只有裸 Pod、DaemonSet、Job 或 CronJob 的命名空间不会作为可选保护应用范围。截图中选择了 test-nginx-2,列表显示该命名空间下有 4 个资源;实际演练时选择你的业务命名空间,例如 dr-pvc-src-170。
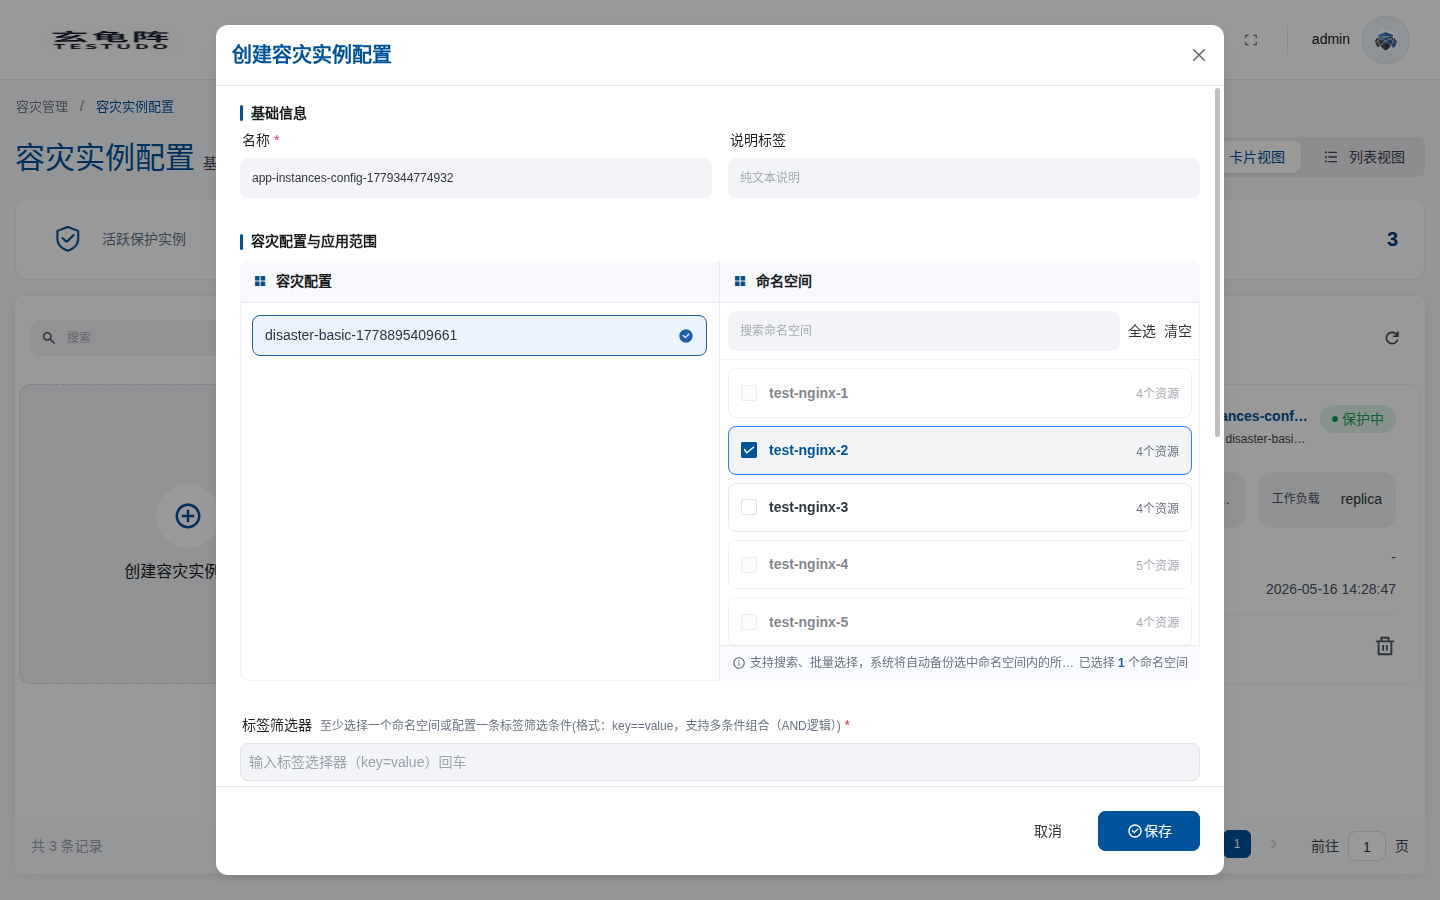
应用范围模块的字段含义:
| 字段 | 说明 |
|---|---|
| 命名空间 | 被保护的业务命名空间;控制台仅展示有运行中 Deployment/StatefulSet 应用的命名空间。至少选择一个命名空间,或配置标签筛选器。 |
| 标签筛选器 | key=value 格式,可用于在命名空间内进一步过滤资源。 |
| 工作负载类型 | 当前示例为 replica,表示目标站点提前恢复资源,但业务副本不主动拉起。 |
配置高级选项
如果源、目标集群的存储类、IngressClass 或资源结构不同,需要展开 高级选项。
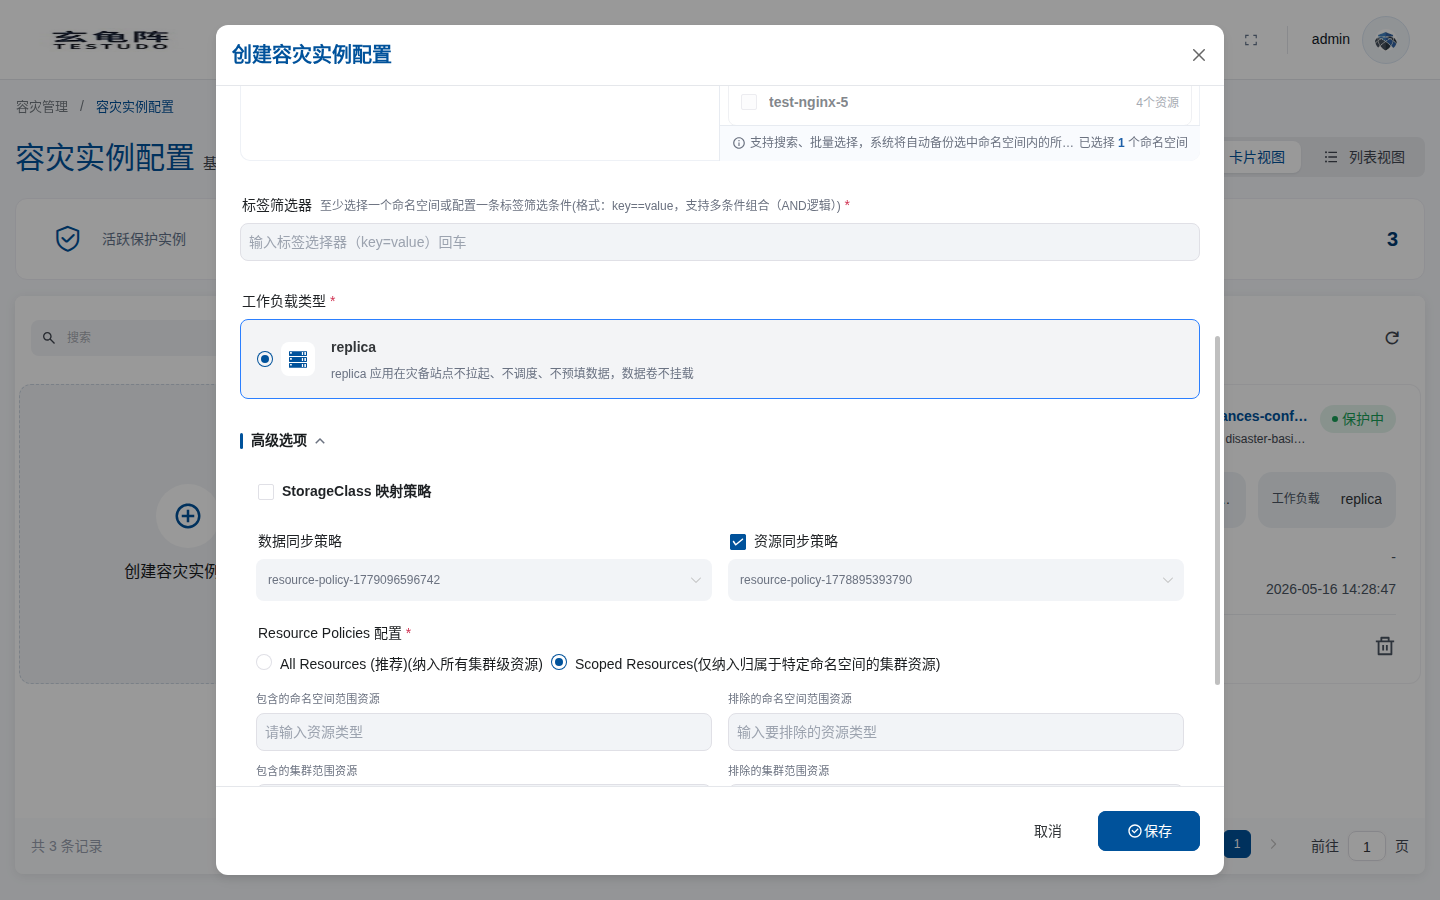
高级选项是可滚动区域,顶部先配置 StorageClass 映射和实例级同步策略。下面的 Resource Policies 用于控制恢复资源范围:
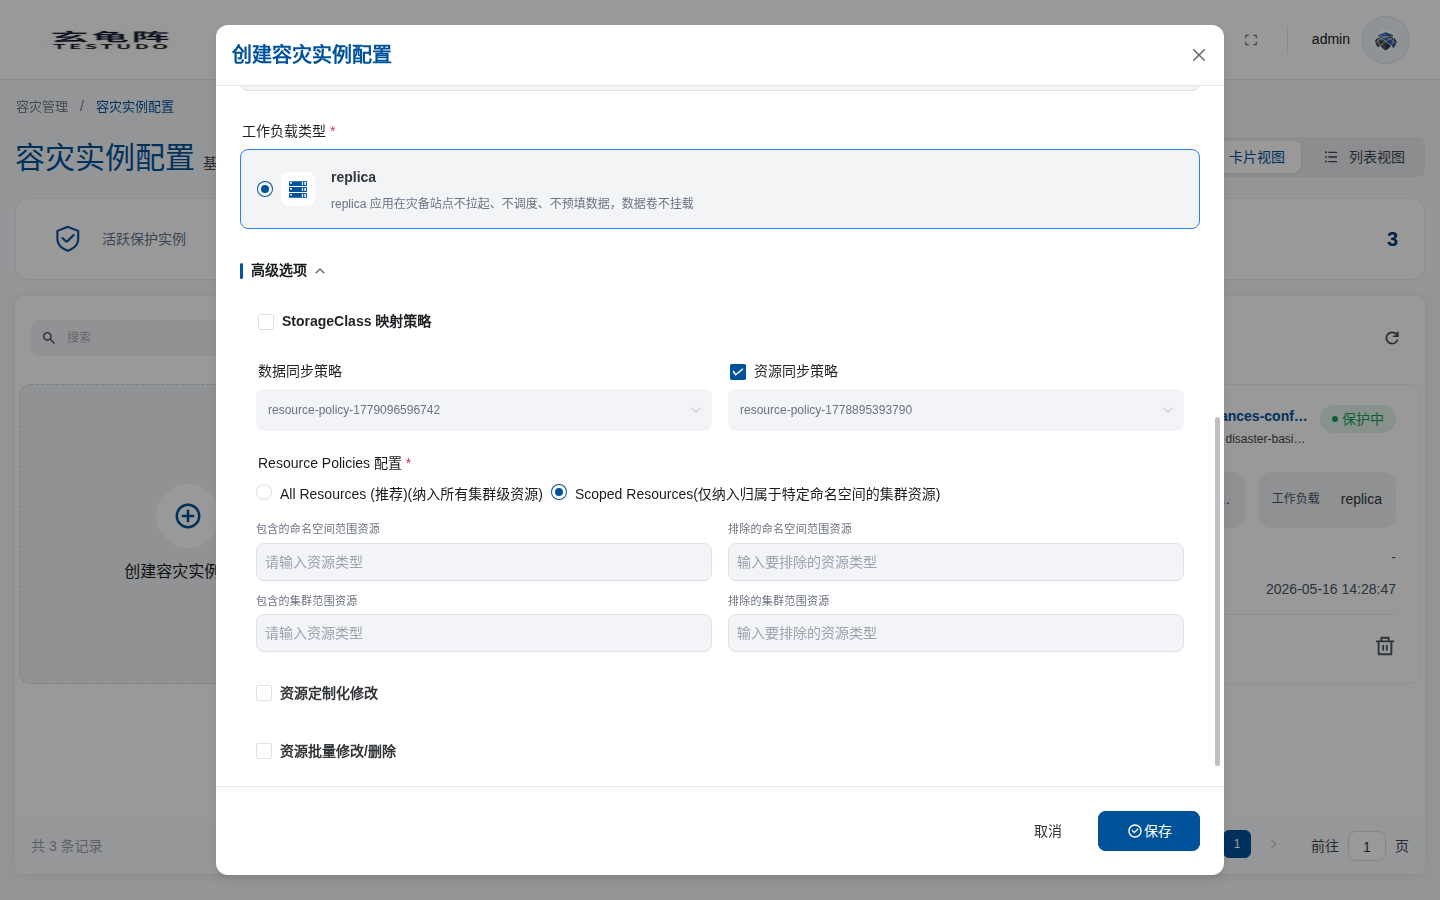
高级选项最终写入 DisasterInstance.spec,不是只影响前端展示。保存后,operator 会在创建 DataSync、ResourceSync、AppRestore 时读取这些字段。
| 模块 | 写入字段 | 作用 |
|---|---|---|
| StorageClass 映射策略 | spec.restorePolicy.storageClassMapping | 源端 PVC 使用的 StorageClass 与目标端 StorageClass 不一致时勾选并配置映射。目标集群仍需要存在对应 StorageClass/provisioner。 |
| 数据同步策略 | spec.dataSyncPolicy | 覆盖基础配置中的数据同步策略;不选择时继承 DisasterConfig。 |
| 资源同步策略 | spec.resourceSyncPolicy | 覆盖基础配置中的资源同步策略;不选择时继承 DisasterConfig。 |
| Resource Policies / 资源精细控制 | spec.restorePolicy.resourceSelection | 控制恢复时包含或排除哪些 namespace、资源类型、集群级资源。 |
| 资源定制化修改 | spec.restorePolicy.modifierRulesText / spec.restorePolicy.modifierRules | 勾选后上传或填写 JSON 规则,在恢复资源落地前执行精确字段修改。详见 资源定制化修改与批量修改删除。 |
| 资源批量修改/删除 | spec.restorePolicy.bulkModifierActionsText / spec.restorePolicy.bulkModifierActions | 勾选后按批量规则生成修改或删除动作,适合统一移除标签、注解、nodeSelector 等字段。详见 资源定制化修改与批量修改删除。 |
当前实例创建表单没有单独的 IngressClass 映射入口。IngressClass、镜像仓库、节点选择器、注解等环境差异,建议通过 资源定制化修改 或 资源批量修改/删除 表达。
标签筛选器表达式
高级选项中的 标签筛选器表达式 用于填写 Kubernetes LabelSelector.matchExpressions。它适合表达普通 key=value 标签筛选器无法覆盖的场景,例如排除某些标签值、要求某个标签存在,或要求某个标签不存在。
普通标签筛选器写入:
DisasterInstance.spec.labelSelector.matchLabels
标签筛选器表达式写入:
DisasterInstance.spec.labelSelector.matchExpressions
控制台中的表达式输入框接收 JSON 数组。留空或填写 [] 表示不追加表达式。
[
  {
    "key": "app",
    "operator": "NotIn",
    "values": ["debug", "test"]
  },
  {
    "key": "backup-disabled",
    "operator": "DoesNotExist"
  }
]
上面的配置表示:只选择 app 标签值不是 debug 或 test 的资源,并且资源上不能存在 backup-disabled 标签。
matchExpressions 中每一项包含三个字段:
| 字段 | 是否必填 | 说明 |
|---|---|---|
key | 是 | 标签 key,例如 app、tier、backup-disabled。 |
operator | 是 | 匹配操作符,支持 In、NotIn、Exists、DoesNotExist。 |
values | 视 operator 而定 | In 和 NotIn 必须填写非空数组;Exists 和 DoesNotExist 不填写或填写空数组。 |
操作符含义:
| operator | 写法示例 | 命中条件 |
|---|---|---|
In | { "key": "app", "operator": "In", "values": ["web", "api"] } | 资源存在 app 标签,且值是 web 或 api。 |
NotIn | { "key": "env", "operator": "NotIn", "values": ["test"] } | 资源没有 env 标签,或 env 的值不是 test。 |
Exists | { "key": "app", "operator": "Exists" } | 资源存在 app 标签,不关心标签值。 |
DoesNotExist | { "key": "backup-disabled", "operator": "DoesNotExist" } | 资源不存在 backup-disabled 标签。 |
如果同时配置了普通标签筛选器和标签筛选器表达式,二者会共同生效,关系是 AND。下面的配置表示:资源必须满足 tier=backend,同时 app 不能是 debug,并且不能带有 backup-disabled 标签。
labelSelector:
  matchLabels:
    tier: backend
  matchExpressions:
    - key: app
      operator: NotIn
      values:
        - debug
    - key: backup-disabled
      operator: DoesNotExist
注意事项:
- 表达式输入框必须填写合法 JSON,属性名和字符串值都要使用双引号。
- 输入内容是数组,不是完整的
labelSelector对象;不要再包一层{ "matchExpressions": ... }。 - 多个表达式之间是 AND 关系,不支持在一个
labelSelector内表达 OR。 - 标签筛选器仍然会和命名空间范围共同收窄资源范围;建议先选定业务命名空间,再用表达式排除测试、临时或不需要保护的资源。
- 使用
NotIn时,没有该标签的资源也会被命中;如果必须要求标签存在并且值不等于某些值,可以同时添加一个Exists表达式。
同步策略覆盖关系
容灾基础配置 DisasterConfig 中通常会配置默认策略:
DisasterConfig.spec.dataSyncPolicy
DisasterConfig.spec.resourceSyncPolicy
实例高级选项可以按字段单独覆盖:
DisasterInstance.spec.dataSyncPolicy
DisasterInstance.spec.resourceSyncPolicy
生效规则是“实例优先,配置兜底”:
| 实例字段 | 基础配置字段 | 实际生效 |
|---|---|---|
| 空 | 有值 | 使用基础配置策略 |
| 有值 | 有值 | 使用实例策略 |
只覆盖 dataSyncPolicy | resourceSyncPolicy 仍继承基础配置 | 数据同步使用实例策略,资源同步使用基础配置策略 |
只覆盖 resourceSyncPolicy | dataSyncPolicy 仍继承基础配置 | 资源同步使用实例策略,数据同步使用基础配置策略 |
server 详情和列表会回显:
{
  "effectiveDataSyncPolicy": "policy-data-fast",
  "effectiveResourceSyncPolicy": "policy-resource-normal",
  "dataSyncPolicySource": "instance",
  "resourceSyncPolicySource": "config"
}
operator 会把实际策略中的 cron 写入 DataSync.spec.trigger.schedule 和 ResourceSync.spec.trigger.schedule。如果策略被禁用或没有可用 schedule,对应同步资源的 schedule 会被清空。
资源精细控制怎么理解
资源精细控制位于:
spec.restorePolicy.resourceSelection
它有两组写法。
旧模型字段:
includedResources: []
excludedResources: []
includeClusterResources: true | false
精细控制字段:
includedNamespaceScopedResources: []
excludedNamespaceScopedResources: []
includedClusterScopedResources: []
excludedClusterScopedResources: []
建议新配置使用精细控制字段,避免 includeClusterResources=true 把范围放大。通过 server/控制台创建时,只要填写了精细控制字段,就会按精细控制模式保存;不要同时依赖 includeClusterResources=true 和 scoped 字段表达同一个意图。
常见含义:
| 字段 | 说明 |
|---|---|
includedNamespaceScopedResources | 只恢复指定 namespace-scoped 资源,例如 deployments.apps、services、configmaps。 |
excludedNamespaceScopedResources | 从 namespace-scoped 资源中排除指定类型。 |
includedClusterScopedResources | 显式恢复指定 cluster-scoped 资源,例如 storageclasses.storage.k8s.io、clusterroles.rbac.authorization.k8s.io。 |
excludedClusterScopedResources | 从 cluster-scoped 资源中排除指定类型。 |
includedNamespaces / excludedNamespaces | 覆盖或补充实例的命名空间范围。 |
labelSelector | 覆盖实例级标签选择器,用于更细粒度过滤。 |
同一组 include/exclude 不能互相冲突。例如 includedNamespaceScopedResources 和 excludedNamespaceScopedResources 不能同时包含同一个资源类型;包含 * 时也不能再和另一组字段组合使用。
通过 server API 创建或更新容灾实例时,这四个字段位于 restorePolicy.resourceSelection 下:
{
  "name": "bookinfo-dr",
  "config": "bookinfo-config",
  "namespaces": ["demo-bookinfo"],
  "restorePolicy": {
    "resourceSelection": {
      "includedNamespaceScopedResources": [
        "deployments.apps",
        "statefulsets.apps",
        "services",
        "configmaps",
        "secrets"
      ],
      "excludedNamespaceScopedResources": ["events", "pods", "replicasets.apps"],
      "includedClusterScopedResources": [],
      "excludedClusterScopedResources": [
        "storageclasses.storage.k8s.io",
        "ingressclasses.networking.k8s.io"
      ]
    }
  }
}
字段值是字符串数组,资源类型使用 Kubernetes API resource 名称,推荐从 kubectl api-resources 的 NAME 列获取;不要传 "deployments,services" 这种逗号字符串。
DataSync 和 ResourceSync 的边界
资源精细控制会同时影响不同恢复链路,但两条链路的职责不同:
| 链路 | 主要职责 | 固定边界 |
|---|---|---|
| DataSync | 恢复 PVC/PV 数据,使用 Trafficless Restore | 主要处理 pods、persistentvolumeclaims、persistentvolumes |
| ResourceSync | 恢复 Kubernetes 资源骨架,保持 standby | 固定排除 pods、persistentvolumeclaims、persistentvolumes,避免和 DataSync 重叠 |
因此,即使在 Resource Policies 中包含了较大的资源范围,ResourceSync 也会回补排除 pods/persistentvolumeclaims/persistentvolumes。PVC/PV 数据应由 DataSync 负责。
包含集群级资源为什么会多恢复一次
当使用精细控制模式,并且 includedClusterScopedResources 非空时,ResourceSync 会把一次资源同步拆成两个恢复阶段:
ResourceSync AppBackup
  -> Cluster Restore phase
  -> Namespace Restore phase
原因是 Velero Restore 对 cluster-scoped 和 namespace-scoped 资源的精细控制能力不同。为了避免把 cluster-scoped 资源隐式带入 namespace 恢复,operator 会显式拆分:
| 阶段 | 触发条件 | 作用 | AppRestore 名称特征 |
|---|---|---|---|
| Cluster phase | includedClusterScopedResources 非空 | 只恢复显式选择的集群级资源,includeClusterResources=true,existingResourcePolicy=None | rec-rs-...-cluster |
| Namespace phase | 精细控制模式下默认执行 | 恢复 namespace-scoped 资源,includeClusterResources=false,existingResourcePolicy=Update,并排除 pods/pvc/pv | rec-rs-...-ns |
所以如果选择了集群级资源,一次 ResourceSync 可能看到两个 AppRestore。这是正常行为,不是重复执行失败。ResourceSync.status 会记录:
lastClusterRestoreName
clusterRestoreStatus
lastNamespaceRestoreName
namespaceRestoreStatus
如果只填写 excludedClusterScopedResources,但没有显式填写 includedClusterScopedResources,ResourceSync 不会启动 cluster phase;系统会按保守策略避免隐式恢复集群级资源。
推荐配置方式
| 场景 | 建议 |
|---|---|
| 普通应用容灾 | 不包含集群级资源,只配置命名空间、必要的 StorageClass 映射,以及必要的 IngressClass/镜像/节点等定制化规则。 |
| 只恢复部分资源类型 | 使用 includedNamespaceScopedResources 精确列出,例如 Deployment、Service、ConfigMap、Secret。 |
| 目标集群已提前安装 CRD、StorageClass、RBAC | 不通过实例恢复这些集群级资源,由平台安装流程管理。 |
| 必须随实例恢复少量集群级资源 | 只填写必要的 includedClusterScopedResources,并预期 ResourceSync 会多一个 cluster restore 阶段。 |
| 需要不同 RPO/RTO | 在实例高级选项中覆盖 dataSyncPolicy 或 resourceSyncPolicy,不要改共享的基础配置策略。 |
关键字段
| 字段 | 说明 |
|---|---|
| 容灾配置 | 引用源集群、目标集群、仓库和同步策略 |
| 命名空间 | 被保护的应用命名空间 |
| 标签选择器 | 在命名空间内进一步缩小资源范围 |
| Pod 恢复方式 | 当前示例为 replica,用于控制目标侧 standby |
| 恢复策略 | 命名空间映射、StorageClass 映射、资源 modifier |
等待进入保护中
保存后,实例会先进入 初始化中,Operator 创建 DataSync 和 ResourceSync,等待首次数据同步和资源同步都完成。
示例实例进入保护态后,列表显示为 保护中:
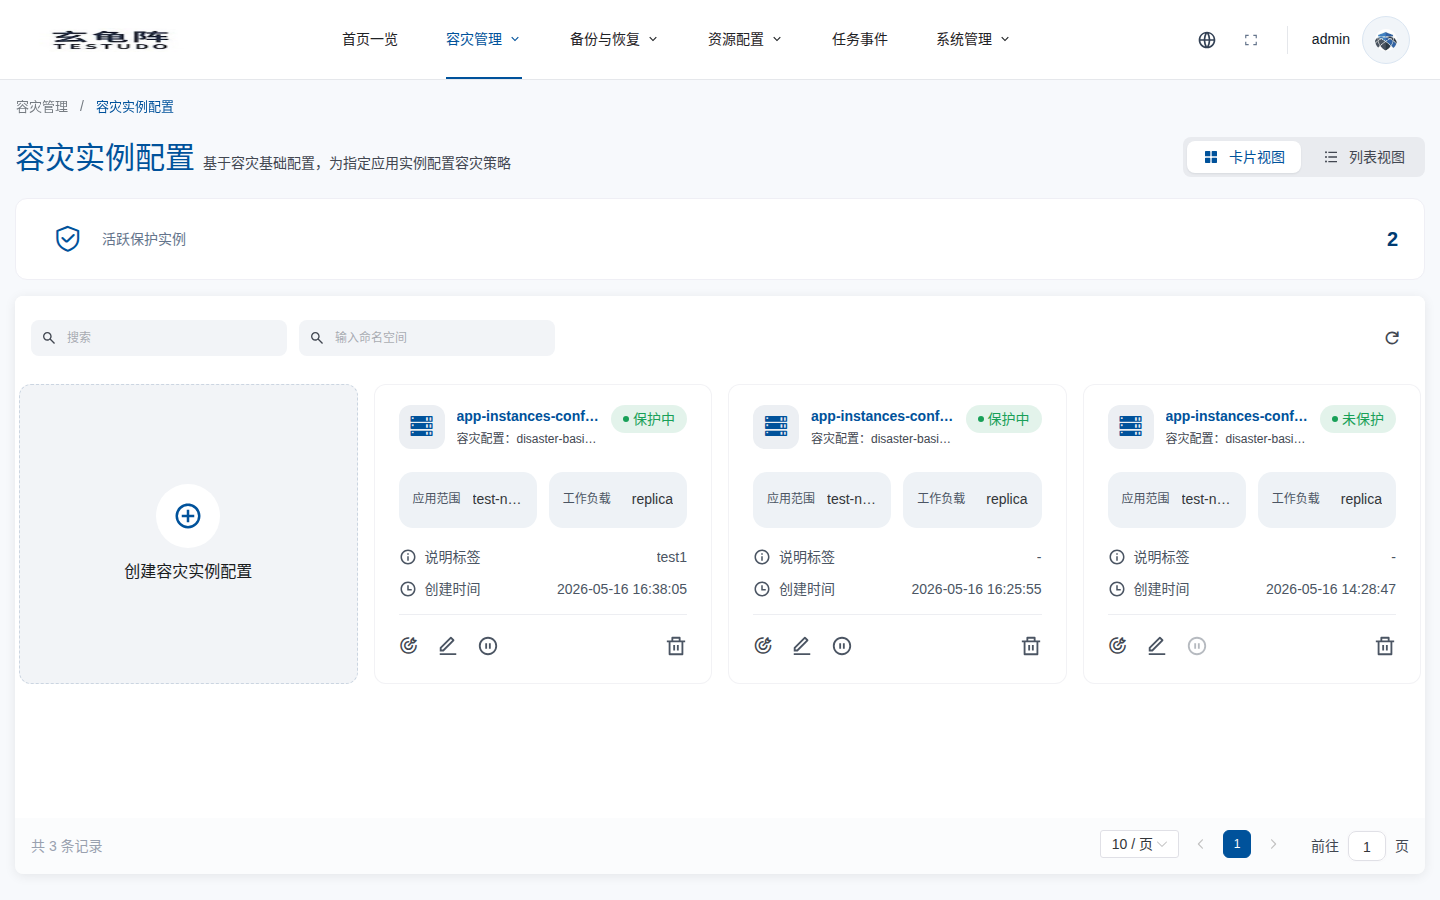
本次验证中,接口返回的关键状态如下:
{
  "fsmState": "Protected",
  "primaryCluster": "ip170-test-001",
  "secondaryCluster": "cluster-ip171-1774332463",
  "availableOperations": ["failover", "pause", "synconce", "syncdata", "syncresource"]
}
状态来源:
- 实例详情:
GET /apis/disasterinstances.testudo.softcdata.com/v1/instances/:name - 同步状态:
GET /apis/disasterinstances.testudo.softcdata.com/v1/instances/:name/sync-status - Operator 逻辑:
DataSync和ResourceSync都 Ready 后,DisasterInstance.status.fsmState切换为Protected。
Standby 模式
ResourceSync 会在目标集群恢复资源骨架。默认 standby 处理会把工作负载副本数设置为 0,并记录原副本数,Failover 时再恢复。
这样可以避免:
- 源和目标同时对外服务。
- 两边同时写同一类外部依赖。
- 目标集群提前消耗过多资源。
验证
kubectl -n disaster-system get disasterinstance docs-walkthrough-20260511
kubectl -n disaster-system get datasync,resourcesync
kubectl -n disaster-system describe datasync dr-ds-docs-walkthrough-20260511
kubectl -n disaster-system describe resourcesync dr-rs-docs-walkthrough-20260511
实例进入 Protected 前不要执行生产切换。首次同步可能因数据量较大耗时较长。