容灾切换流程
Testudo V2 的容灾切换采用 Pilot Light(长明火) 模式。正常保护期间,数据和资源持续同步到备集群;备集群提前保留可切换的资源骨架,但工作负载默认保持 replicas=0,不对外提供业务流量。发生切换时,operator 拉起备集群工作负载,并更新实例的主备角色。
本文说明实例级 Failover 的执行流程。具体控制台操作示例见 执行实例级故障切换 Failover。
如果切换步骤失败或超时,operator 会按失败阶段尝试自动补偿。补偿机制见 容灾切换失败自动补偿机制。
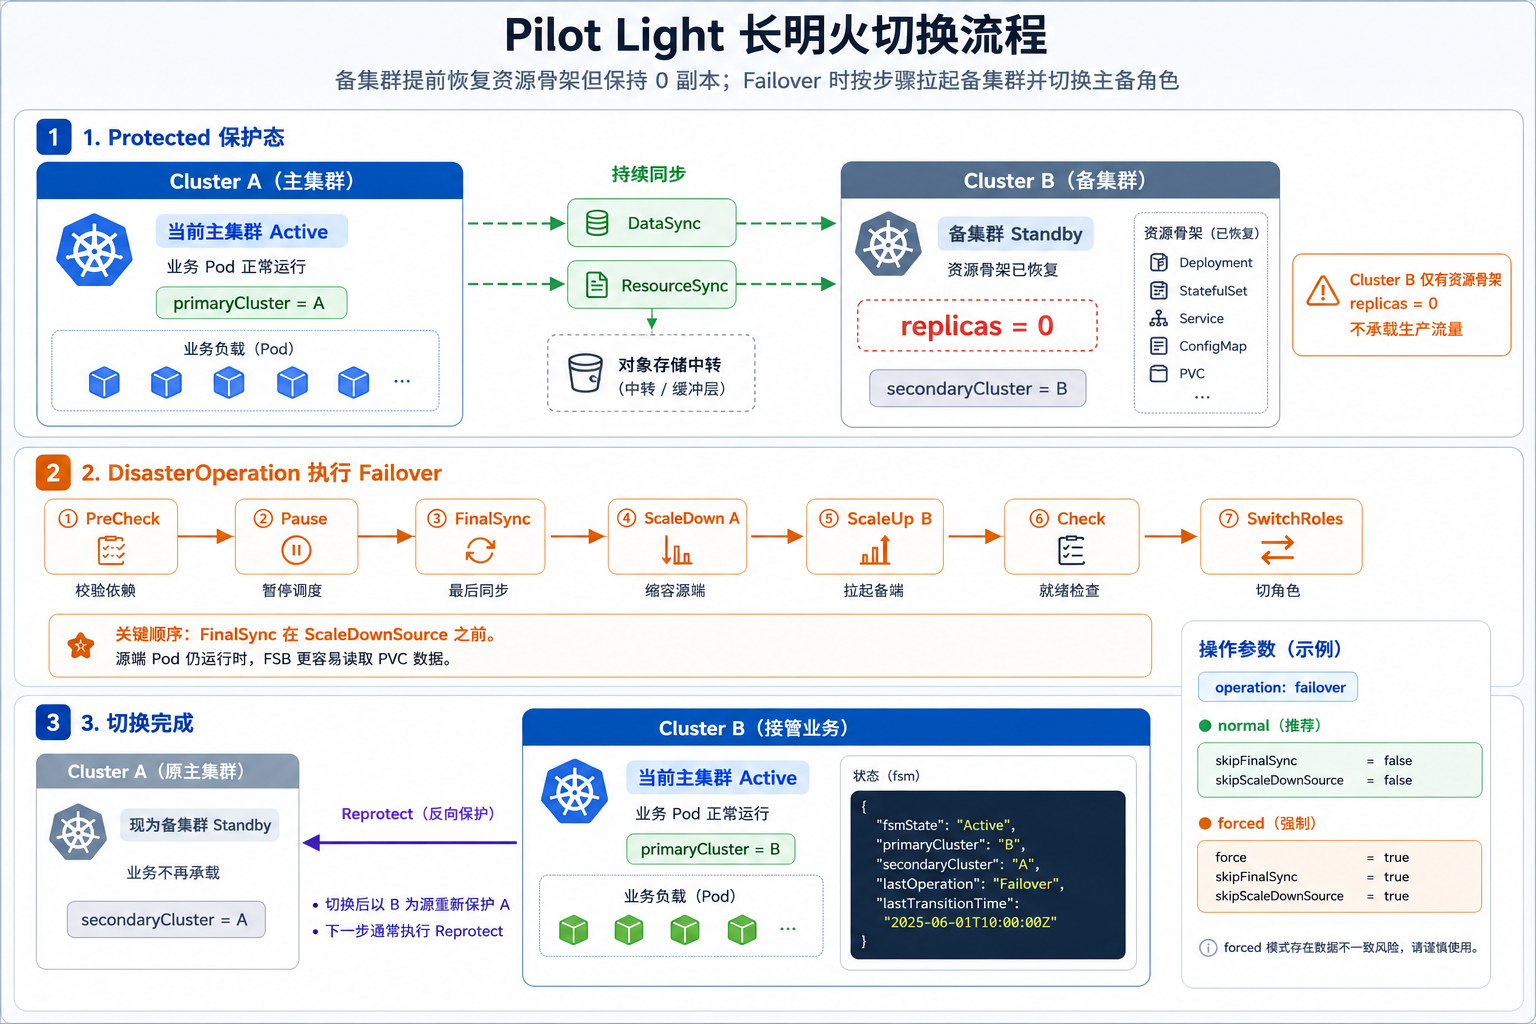
可编辑图源:pilot-light-failover-workflow.excalidraw
长明火模式
长明火模式下,容灾实例在 Protected 状态时保持以下关系:
| 对象 | 主集群 | 备集群 |
|---|---|---|
| 业务工作负载 | 正常运行 | 已恢复资源骨架,副本数为 0 |
| 数据 | 持续备份 | 持续恢复或准备恢复 |
| Kubernetes 资源 | 原始资源 | 经 ResourceSync 恢复后的 standby 资源 |
| 对外流量 | 由外部流量系统指向主集群 | 不承载生产流量 |
这种模式的目标是降低冷恢复时间。切换时不需要从零创建全部资源,而是基于备集群已有的资源骨架拉起工作负载。
前置状态
执行 Failover 前,实例通常应处于 Protected 状态:
primaryCluster   = 当前主集群
secondaryCluster = 当前备集群
fsmState         = Protected
同时应确认:
- DataSync 最近一次同步成功。
- ResourceSync 最近一次同步成功。
- 目标集群存在 standby 资源。
- 目标集群具备业务镜像、Secret、StorageClass、IngressClass、CRD 和网络依赖。
- 外部 DNS、网关、负载均衡或流量切换方案已准备。
Testudo 负责 Kubernetes 资源和数据同步编排,不直接替代外部全局流量管理。
标准切换步骤
Failover 会创建 operationType=failover 的 DisasterOperation。当前实现的步骤顺序是:
PreCheck
  -> PauseSchedules
  -> FinalSync
  -> ScaleDownSource
  -> ScaleUpTarget
  -> CheckReplicas
  -> SwitchRoles
1. PreCheck
operator 检查实例、基础配置、集群、存储仓库、ResourceSync/DataSync 状态和资源修改规则。
这一步会尽量在破坏性动作前发现问题。如果预检查失败,操作不会进入源端缩容。
2. PauseSchedules
暂停 DataSync 和 ResourceSync 的周期调度,避免切换过程中又触发新的同步任务。
3. FinalSync
触发最后一次 DataSync 和 ResourceSync,并等待同步完成。
当前实现中,FinalSync 必须在 ScaleDownSource 之前执行。原因是 Velero FSB 依赖仍在运行的 Pod 读取 PVC 数据;如果先把源端 Pod 缩到 0,最后一次数据同步可能无法包含 PVC 数据。
如果用户选择跳过最终同步,operator 会跳过该步骤,使用最近一次成功同步点进行切换。
4. ScaleDownSource
缩容当前主集群中的受保护工作负载,降低双写和脑裂风险。
执行缩容前,operator 会记录工作负载原始副本数,用于后续在目标集群恢复副本数。记录失败不会直接阻断切换,但会产生告警事件。
如果用户选择跳过源端缩容,operator 不会修改源集群工作负载。此时必须依赖外部流量治理或人工手段避免源、目标两端同时写入。
5. ScaleUpTarget
在当前备集群中恢复 Deployment、StatefulSet 等工作负载副本数。
operator 优先读取 ResourceSync 记录的副本数;如果目标集群资源仍是 standby 形态,即 replicas=0,则按记录恢复为原始副本数。
6. CheckReplicas
检查目标集群工作负载副本是否达到期望状态。
如果配置了等待 Pod 就绪,operator 会等待目标侧 Pod Ready 后再继续。若选择跳过容器就绪检查,该步骤只做较轻量的状态确认。
7. SwitchRoles
切换实例角色关系:
切换前:
primaryCluster   = A
secondaryCluster = B
fsmState         = Protected

切换后:
primaryCluster   = B
secondaryCluster = A
fsmState         = Active
切换成功后,实例进入 Active。这表示目标集群已经接管业务,但当前实例还没有重新建立反向保护,所以控制台通常展示为未保护或待反向保护状态。
切换参数
常用参数如下:
| 参数 | 含义 | 典型场景 |
|---|---|---|
skipFinalSync | 跳过最后一次同步 | 源集群不可达,或需要使用最近一次成功同步点快速切换 |
skipScaleDownSource | 跳过源端缩容 | 源集群不可达,或由外部系统确保源端不会继续接收写流量 |
force | 允许源集群不可达时继续执行 | 灾难场景,源集群 API Server 无法访问 |
timeoutMinutes | 操作超时时间 | 大数据量最终同步或大规模工作负载拉起时应适当调大 |
skipPodReadyCheck | 跳过 Pod Ready 检查 | 业务健康由外部系统确认,或需要先完成资源层切换 |
标准生产切换通常不跳过最终同步,也不跳过源端缩容:
{
  "operation": "failover",
  "config": {
    "skipFinalSync": false,
    "skipScaleDownSource": false,
    "force": false,
    "timeoutMinutes": 30,
    "skipPodReadyCheck": false
  }
}
源集群不可达时,通常使用强制切换参数:
{
  "operation": "failover",
  "config": {
    "force": true,
    "skipFinalSync": true,
    "skipScaleDownSource": true,
    "timeoutMinutes": 30
  }
}
强制切换会牺牲最后一次同步点,RPO 取决于最近一次成功同步结果。
API
实例级切换接口:
POST /apis/disasterinstances.testudo.softcdata.com/v1/instances/:name/actions
请求示例:
{
  "operation": "failover",
  "config": {
    "timeoutMinutes": 30,
    "skipFinalSync": false,
    "skipScaleDownSource": false,
    "skipPodReadyCheck": false
  }
}
组级切换接口:
POST /apis/disastergroups.testudo.softcdata.com/v1/groups/:name/actions
组级 Failover 会按 DisasterGroup 的 levels 展开实例切换。同一 level 内可以并行执行,下一 level 会等待当前 level 完成。
观察切换进度
查看实例状态:
kubectl -n disaster-system get disasterinstance <instance-name> -o wide
kubectl -n disaster-system get disasterinstance <instance-name> -o yaml
查看操作状态和步骤:
kubectl -n disaster-system get disasteroperation \
  -l testudo.softcdata.com/instance=<instance-name>

kubectl -n disaster-system describe disasteroperation <operation-name>
重点关注:
status.statestatus.currentStepstatus.stepsstatus.reasonstatus.messagestatus.autoCancelTriggeredstatus.autoCancelStatusstatus.autoCancelModestatus.autoCancelStepsstatus.manualInterventionRequired
切换后处理
Failover 成功后,需要根据业务决策选择后续动作:
| 操作 | 适用场景 | 结果 |
|---|---|---|
| 反向保护 Reprotect | 目标集群已接管生产,后续长期以目标集群为主 | 重新建立 B -> A 的保护关系,实例回到 Protected |
| 撤销切换 Undo | 误切或临时切换后需要回到原主集群 | 缩容当前目标,拉起原主,恢复 A -> B 保护关系 |
| 中止 Cancel | 操作卡住或人工决定停止当前操作 | 停止继续执行,之后必须人工检查资源状态 |
切换完成后还应执行:
- 验证目标集群 Pod、Service、PVC 和入口资源。
- 验证业务读写路径。
- 切换或确认外部 DNS、网关、负载均衡。
- 记录 RTO、RPO 和操作结果。
- 确认是否立即执行 Reprotect。
常见风险
| 风险 | 说明 | 建议 |
|---|---|---|
| 跳过最终同步导致数据点落后 | 使用最近一次成功同步点切换 | 灾难场景可接受,计划切换不建议跳过 |
| 跳过源端缩容导致双写 | 源、目标可能同时运行 | 必须先切断源端入口或由外部流量系统保证单写 |
| 目标镜像拉取失败 | 业务镜像、Secret 或 registry 配置缺失 | 切换前在目标集群验证镜像和 imagePullSecret |
| 目标依赖缺失 | StorageClass、IngressClass、CRD、外部服务未准备 | 在 ResourceSync 阶段提前排查恢复事件 |
| Pod Ready 超时 | 镜像、探针、依赖或容量问题 | 查看目标集群 Pod event 和 DisasterOperation.status.steps |
与演练的区别
Failover 会切换主备角色,并可能缩容源端;演练不会交换主备角色,也不应影响生产 standby 资源。演练完成后,实例仍保持原来的保护方向。
因此,生产切换前应先用演练验证恢复策略、资源映射和目标集群依赖,但不能把演练完成等同于已经完成生产 Failover。