查看演练结果、重跑和清理
当前控制台没有独立的“导出演练报告”流程。演练结果主要通过 容灾管理 / 容灾演练 列表、演练状态、执行步骤和相关 DisasterOperation 查看。
查看演练结果
进入 容灾管理 / 容灾演练。列表或卡片会展示:
- 演练任务名称。
- 容灾对象:容灾实例或容灾组。
- 演练目标集群。
- 创建时间。
- 最近演练时间:来自演练完成时间。
- 演练状态。
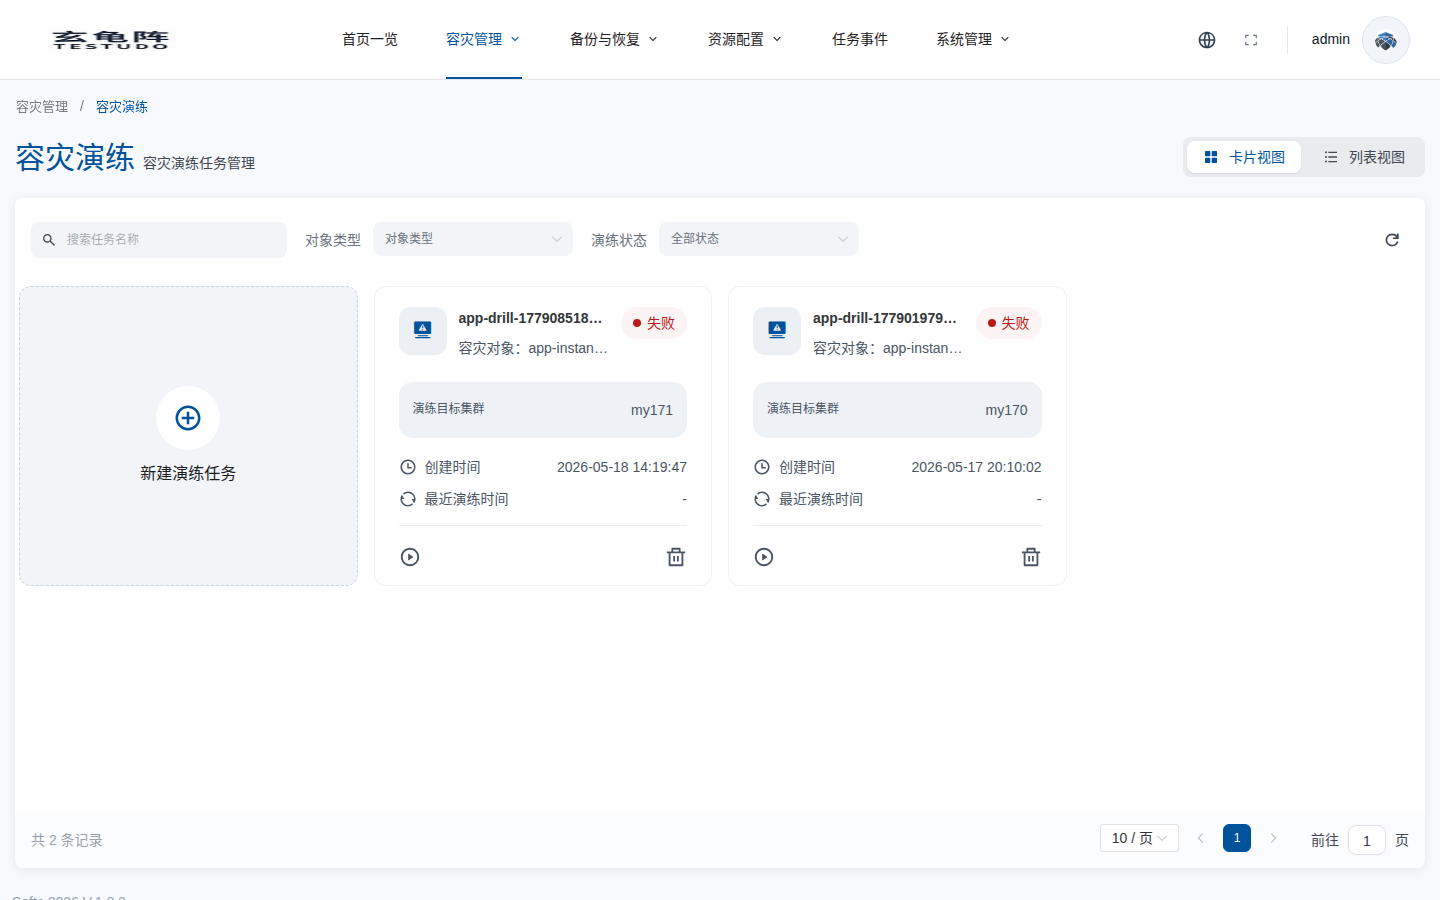
状态筛选与后端状态的对应关系如下:
| 控制台筛选 | 后端状态 | 说明 |
|---|---|---|
| 未演练 | Pending / Ready | 已创建,正在校验或已校验通过,等待执行。 |
| 演练中 | Executing | 已确认执行,正在推进恢复和扩容步骤。 |
| 已完成 | Completed | 演练执行完成,可以执行清理。 |
| 失败 | Failed | 校验、执行或清理失败。 |
| 清理中 | CleaningUp | 已触发清理,正在等待清理 operation 完成。 |
| 已清理 | CleanedUp | 演练资源清理完成。 |
如果需要查看更完整的状态,可以查看演练详情或直接查询 CR:
kubectl -n disaster-system get disasterdrill <drill-name> -o yaml
重点关注:
status.state:当前状态。status.reason/status.message:失败原因和错误信息。status.restoreMode:当前版本通常为FullRestore。status.currentStep:当前步骤。status.steps:每个步骤的状态、开始时间、结束时间和消息。status.validationResults:前置校验结果。status.groupProgress:组演练的层级进度。
执行演练
演练创建后会先进入 Pending,operator 完成前置校验后进入 Ready。只有 Ready 状态可以确认执行。
控制台点击 执行演练 后,会弹出执行确认窗口;确认后 server 调用:
POST /apis/disasterdrills.testudo.softcdata.com/v1/drills/:name/confirm
该接口会把 spec.confirmed 设置为 true。operator 随后创建演练用的 DisasterOperation,并进入 Executing。
当前实例级演练固定使用完整恢复链路,执行步骤通常是:
RestoreResource -> RestoreData -> ScaleUp
RestoreResource:使用 ResourceSync 最近一次资源备份创建资源恢复。RestoreData:使用 DataSync 最近一次数据备份恢复 PVC 数据。ScaleUp:按记录的副本数扩容目标集群工作负载。
查看执行细节
演练的 status.operationName 会记录当前关联的 DisasterOperation。可以用它继续排查步骤和恢复对象:
op=$(kubectl -n disaster-system get disasterdrill <drill-name> -o jsonpath='{.status.operationName}')
kubectl -n disaster-system get disasteroperation "$op" -o yaml
如果要继续查看资源恢复和数据恢复对象:
resource_restore=$(kubectl -n disaster-system get disasteroperation "$op" -o jsonpath='{.status.resourceRestoreName}')
data_restore=$(kubectl -n disaster-system get disasteroperation "$op" -o jsonpath='{.status.dataRestoreName}')

kubectl -n disaster-system get apprestore "$resource_restore" -o yaml
kubectl -n disaster-system get apprestore "$data_restore" -o yaml
这些对象比列表页更适合用来定位失败步骤,例如备份不可用、目标集群恢复失败、PVC 恢复失败、Pod Ready 等问题。
重跑演练
当前平台页面没有“重跑演练”按钮,也没有直接重跑的操作入口。需要再次验证时,在平台上新建一条演练任务。
server 侧保留了重跑接口,主要用于接口级集成或后续扩展:
POST /apis/disasterdrills.testudo.softcdata.com/v1/drills/:name/restart
重跑接口只允许在 Completed 或 Failed 状态调用。它不是直接继续执行原来的 operation,而是给 DisasterDrill 写入重跑时间戳;operator 看到后会:
- 将
spec.confirmed重置为false。 - 清空旧的 status。
- 把状态重置为
Pending。 - 重新执行前置校验。
- 校验通过后再次进入
Ready,仍需要再次确认执行。
如果演练已经进入 CleaningUp 或 CleanedUp,不要按重跑处理。需要重新验证时,建议新建一条演练任务。
清理演练资源
清理只允许在 Completed 状态触发。控制台中,演练完成后主操作会从 执行演练 变为 执行清理;点击后 server 调用:
POST /apis/disasterdrills.testudo.softcdata.com/v1/drills/:name/cleanup
该接口会把 spec.cleanup 设置为 true。operator 随后创建 operationType=drill-cleanup 的 DisasterOperation,并把演练状态推进为 CleaningUp。
清理行为取决于是否配置了命名空间映射:
| 场景 | 清理行为 |
|---|---|
配置了 namespaceMapping | 删除目标集群中映射后的演练命名空间。 |
未配置 namespaceMapping | 不删除命名空间;只把目标集群工作负载缩容到 0,避免误删真实备端资源。 |
清理完成后状态变为 CleanedUp。如果清理 operation 失败,演练状态会变为 Failed,status.reason/status.message 会记录失败原因。
重复点击清理不会创建新的清理任务;spec.cleanup=true 后再次调用清理接口会被拒绝。
删除不等于清理
控制台的删除按钮删除的是 DisasterDrill 任务对象,不等同于清理目标集群上的演练资源。
建议顺序是:
- 演练完成后先保存必要证据。
- 对
Completed状态的演练执行清理。 - 确认状态变为
CleanedUp。 - 再按需要删除演练任务对象。
删除演练任务前,可以先检查依赖关系和清理计划,避免误删仍需要排查的 DisasterOperation、事件和恢复对象。
建议记录的信息
每次正式演练至少记录:
- 演练对象:实例或组。
- 目标集群和命名空间映射。
- 创建时间、确认执行时间、完成时间。
status.state、status.reason、status.message。status.steps中每个步骤的耗时和结果。- 关联的
DisasterOperation名称。 - 资源恢复和数据恢复的
AppRestore名称。 - RTO:从确认执行到应用 Ready 的耗时。
- RPO:恢复点距离源端最新数据的时间差。
- 人工处理步骤和下次演练前必须修复的问题。