数据同步原理
Testudo 的数据同步不是数据库级实时复制,而是围绕 Velero 构建的 周期性备份 + 目标端恢复 链路。DataSync 负责调度和编排,AppBackup 在当前主集群触发 Velero Backup,AppRestore 在备集群触发 Velero Restore,底层 PVC 数据通过 Velero FSB 写入对象存储并恢复到目标 PVC。
这个机制适合 Pilot Light(长明火)容灾模式:备集群提前准备资源骨架,数据按策略持续同步;真正 Failover 时,目标集群不需要从零开始恢复全部数据。
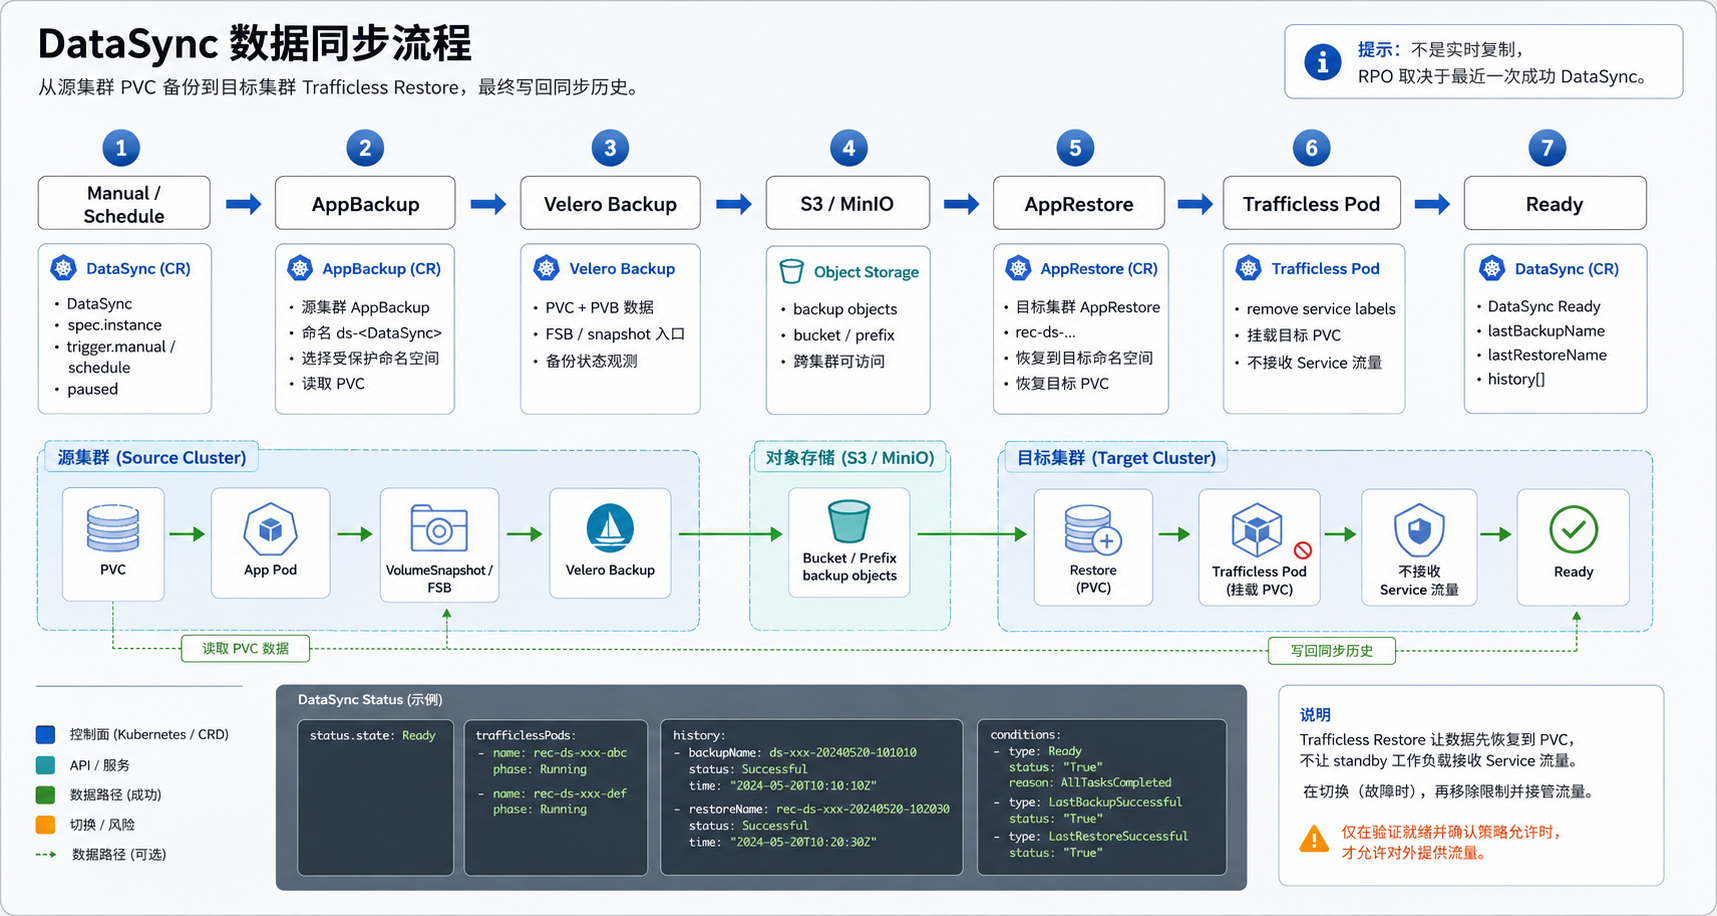
可编辑图源:data-sync-flow.excalidraw
一句话模型
DisasterInstance
  -> DataSync
  -> AppBackup  -> 源集群 Velero Backup  -> 对象存储
  -> AppRestore -> 目标集群 Velero Restore -> 目标 PVC
其中:
| 层级 | 对象 | 职责 |
|---|---|---|
| 用户意图 | DisasterInstance | 定义要保护的命名空间、标签选择器、恢复策略和主备关系 |
| 同步控制 | DataSync | 注册调度、触发同步、串联备份和恢复、记录同步历史 |
| 备份封装 | AppBackup | 在源集群创建和观测 Velero Backup |
| 恢复封装 | AppRestore | 在目标集群创建和观测 Velero Restore |
| 数据面 | Velero FSB | 读取源端 Pod 挂载卷,把文件数据写入对象存储,再恢复到目标端 PVC |
| 存储 | StorageRepository / BSL | 为 Velero 提供 S3/MinIO 等对象存储访问配置 |
同步方向
DataSync 的同步方向始终跟随实例的当前主备角色。
当 DisasterInstance.status.primaryCluster 和 secondaryCluster 已存在时:
source = primaryCluster
target = secondaryCluster
如果实例还没有写入运行时角色,则回退使用 DisasterConfig 中的静态配置:
source = DisasterConfig.spec.sourceCluster
target = DisasterConfig.spec.targetCluster
这意味着 Failover 或 Reprotect 之后,DataSync 不需要换一套资源名。operator 会根据新的主备角色把同步方向调整为新主集群到新备集群。
触发方式
DataSync 有三类触发入口。
| 触发方式 | 说明 |
|---|---|
| 首次同步 | status.lastSyncTime 为空时,operator 会触发一次同步,推动实例进入可保护状态 |
| 周期同步 | spec.trigger.schedule 使用 5 字段 cron 表达式,由 operator 内部 SyncScheduler 注册 |
| 手动同步 | 更新 spec.trigger.manual 为新的 RFC3339 时间戳,立即触发一次同步 |
当 spec.paused=true 时,周期调度会被移除;已经进行中的同步会继续推进。手动触发用于运维动作,例如发布前创建新恢复点、修改恢复策略后验证目标端,或者 Failover 的 FinalSync。
如果上一次同步仍处于 InProgress,新的周期触发会被跳过,避免同一个 DataSync 并发写入同一组备份和恢复状态。
备份阶段
同步开始后,operator 先确认 StorageRepository 可用,然后创建或复用长期存在的 AppBackup:
AppBackup name = ds-<DataSync name>
每次同步不会重新创建一个新的 AppBackup 对象,而是在这个对象上写入一次 spec.action:
spec:
  action:
    type: Backup
    requestAt: "<当前时间>"
AppBackup 看到 action 后,会在源集群的 velero 命名空间创建 Velero Backup。DataSync 使用的备份模板大致是:
includedNamespaces:
  - <实例保护的命名空间>
excludedNamespaces:
  - velero
  - kube-system
includedResources:
  - pods
  - persistentvolumeclaims
  - persistentvolumes
snapshotVolumes: false
defaultVolumesToFsBackup: true
storageLocation: <StorageRepository 对应的 BSL>
这里最关键的是:
| 字段 | 含义 |
|---|---|
includedResources 包含 pods/pvc/pv | Velero FSB 需要 Pod 和卷信息来定位要备份的数据 |
snapshotVolumes=false | 不走 CSI VolumeSnapshot 作为主路径 |
defaultVolumesToFsBackup=true | 使用 Velero 文件系统备份 FSB |
storageLocation | 指向对象存储,对应实际 Velero BackupStorageLocation |
运行时 BSL 会带集群后缀:
<StorageRepository>-<sourceCluster>
BSL 的对象存储 prefix 使用源集群名称。这样多个集群可以共用一个 bucket,但备份对象不会互相覆盖。
恢复阶段
当源端 Velero Backup 完成后,DataSync 会创建目标端 AppRestore:
AppRestore name = rec-ds-<DataSync name 前缀>-<BackupName hash>
目标端 AppRestore 会先确保目标集群具备读取源端备份的 BSL:
BSL name = <StorageRepository>-<sourceCluster>
prefix   = <sourceCluster>
然后在目标集群创建 Velero Restore。数据同步恢复模板大致是:
backupName: <本次 Velero Backup 名称>
includedNamespaces:
  - <实例保护的命名空间>
includedResources:
  - pods
  - persistentvolumeclaims
  - persistentvolumes
restorePVs: true
existingResourcePolicy: None
preserveNodePorts: true
正常 DataSync 使用 existingResourcePolicy=None,避免覆盖已经存在的 standby 资源。演练场景可以使用 Update 策略覆盖演练环境中的已存在资源。
如果实例配置了恢复策略,operator 会在构建 AppRestore 时应用对应的策略,例如 StorageClass 映射、资源修改规则、命名空间或镜像相关规则。DataSync 会以 dataSync 作为规则应用目标,因此只应配置适合数据恢复阶段执行的规则。
PVC volumeName 清理
DataSync 在首次初始化数据恢复时,还会注入一条系统级 ResourceModifier,用来清理 PVC 的静态卷绑定:
resourceModifierRules:
  - conditions:
      groupResource: persistentvolumeclaims
      namespaces:
        - <实例保护的命名空间>
    patches:
      - operation: remove
        path: /spec/volumeName
原因是 Velero 备份中的 PVC 可能带有源集群的 spec.volumeName。这个字段表示 PVC 已绑定到某个具体 PV 名称,而源集群的 PV 名称在目标集群中通常不可直接复用。直接恢复这个绑定可能导致目标端 PVC 继续指向不存在的源端 PV,或者和目标集群动态制备出来的 PV 发生冲突。
当前实现只在下面这个确定时机注入该清理规则:
DataSync.status.lastSyncTime == nil
AND DisasterInstance.status.fsmState == Initializing
也就是说,它只作用于实例初始化阶段的第一次 DataSync 恢复。第一次同步完成后,后续周期同步不再自动清理 volumeName,避免破坏目标端已经稳定绑定的 PVC。
清理 volumeName 后,目标端 PVC 必须重新完成绑定。因此目标集群必须具备可用的 StorageClass/provisioner,或者提前准备满足 PVC 规格的静态 PV。如果目标端既没有动态制备能力,也没有可绑定的 PV,PVC 会保持 Pending,Trafficless Pod 无法挂载卷,Velero 的 PodVolumeRestore / DataDownload 也无法完成。
如果实例没有配置 restorePolicy,operator 会把这条规则直接追加到 DataSync 的 AppRestore.spec.resourceModifierRules。如果实例配置了 restorePolicy,operator 会把它作为 system-protect 规则参与编译,确保用户自定义规则不能覆盖这条安全补丁。
演练数据恢复也有同类保护:当演练 namespaceMapping 把源命名空间恢复到不同目标命名空间时,operator 会对映射后的目标命名空间注入 PVC volumeName 清理规则,避免演练 PVC 带着源端 PV 绑定进入新命名空间。
为什么需要 Trafficless Restore
Velero FSB 的数据恢复依赖目标端 Pod 挂载 PVC。问题在于 Pilot Light 模式下,备集群的业务工作负载通常保持 replicas=0:
目标集群已有 StatefulSet / Deployment / PVC
但是没有业务 Pod 在运行
如果没有 Pod,Velero Node Agent 没有可以写入的挂载点;如果直接恢复业务 Pod,它可能被 Service selector 选中,提前接收生产流量,或者被 Deployment/StatefulSet 控制器接管。
Trafficless Restore 的做法是恢复一个“不接流量、只负责挂载 PVC 接收数据”的临时 Pod。
临时 Pod 怎么做到不接流量
DataSync 在创建 AppRestore 时自动注入 ResourceModifier,只对 pods 生效:
resourceModifierRules:
  - conditions:
      groupResource: pods
    patches:
      - operation: add
        path: /metadata/labels
        value: '{"trafficless": "true"}'
      - operation: add
        path: /metadata/ownerReferences
        value: '[]'
      - operation: replace
        path: /spec/containers/0/image
        value: busybox:1.36
      - operation: add
        path: /spec/containers/0/command
        value: '["sleep","3600"]'
这些修改分别解决不同问题:
| 修改 | 作用 |
|---|---|
替换 labels 为 trafficless=true | 让 Service selector 匹配不到这个 Pod,避免业务流量进入 |
清空 ownerReferences | 避免 Deployment/StatefulSet/GC 立即接管或删除这个 Pod |
替换镜像为 busybox:1.36 | 避免启动真实业务进程 |
写入 sleep 3600 | 保持 Pod 存活,给 Velero Node Agent 足够时间恢复卷数据 |
Pod 名称、卷挂载关系和 PVC 关系仍来自备份内容,因此 Velero 能根据原始 Pod 卷信息把数据写入目标 PVC。恢复完成后,DataSync 会清理目标集群里标记为 trafficless=true 的临时 Pod。
离线环境要注意:Trafficless Pod 的镜像也需要目标集群能拉取。它不是 Velero 安装镜像,和 veleroInstall.imageRegistry 不是同一个用途;如果目标集群不能访问 Docker Hub,需要把 trafficlessConfig.image 或恢复策略中的镜像规则配置为内网镜像。
和 ResourceSync 的关系
DataSync 只解决 PVC 数据怎么到目标集群,不负责把完整业务资源恢复成 standby 形态。长明火模式需要 DataSync 和 ResourceSync 配合:
| 链路 | 主要同步内容 | 目标端结果 |
|---|---|---|
ResourceSync | Deployment、StatefulSet、Service、ConfigMap、Secret、PVC 等资源骨架 | 工作负载存在但通常 replicas=0 |
DataSync | Pod、PVC、PV 及卷内文件数据 | 目标 PVC 中已有最近一次同步的数据 |
因此,健康的保护状态通常要求:
DataSync   = Ready
ResourceSync = Ready
DisasterInstance.fsmState = Protected
如果 ResourceSync 没有先把 PVC 或相关资源准备好,DataSync 恢复阶段可能因为目标端依赖缺失而失败。
和 Failover 的关系
Failover 会执行 FinalSync,也就是在切换前再触发一次 DataSync 和 ResourceSync。
当前实现中,FinalSync 必须在源端 ScaleDownSource 之前执行:
PauseSchedules
  -> FinalSync
  -> ScaleDownSource
  -> ScaleUpTarget
原因是 FSB 备份需要源端 Pod 仍然运行,才能读取 Pod 挂载的 PVC 数据。如果先把源端工作负载缩到 0,最后一次数据同步可能无法覆盖 PVC 数据。
如果源集群已经不可达,可以在操作参数中跳过最终同步,使用最近一次成功的 DataSync 恢复点进行切换。这种方式会增加 RPO 风险,应该只在源端不可用或必须快速切换时使用。
一致性边界
DataSync 提供的是文件系统级备份恢复编排,不保证数据库事务级一致性。
需要特别关注:
| 场景 | 风险 | 建议 |
|---|---|---|
| 数据库、消息队列等有写入中的服务 | 备份时间点可能存在应用内未刷盘或事务不一致 | 配合应用级冻结、备份钩子、只读窗口,或使用数据库原生复制 |
| 大数据量 PVC | 单次 FSB 备份恢复耗时长,RPO 可能超过调度周期 | 评估数据量、对象存储吞吐、网络带宽和 Velero Node Agent 资源 |
| 多 PVC 应用 | 不同卷之间的业务一致性依赖应用自身 | 在业务低峰执行同步或通过应用机制保证一致点 |
| 源端 Pod 已停止 | FSB 可能无法读取最新 PVC 内容 | 正常切换时不要在 FinalSync 前缩容源端 |
因此,DataSync 更适合作为 Kubernetes 应用级容灾的数据面基础;对强一致数据库,应结合数据库原生高可用或复制方案。
状态和历史
DataSync 的关键状态字段包括:
| 字段 | 说明 |
|---|---|
status.state | Ready、InProgress、Failed |
status.reason / status.message | 失败原因和可读错误信息 |
status.lastSyncTime | 最近一次同步完成时间 |
status.lastBackupName | 最近一次关联的 Velero Backup 名称 |
status.lastRestoreName | 最近一次关联的 AppRestore 名称 |
status.history | 最近同步历史,包含备份名、恢复名、资源数量、耗时和结果 |
status.conditions | 控制器写入的条件状态 |
常用查看命令:
kubectl -n disaster-system get datasync
kubectl -n disaster-system get datasync <datasync-name> -o yaml

kubectl -n disaster-system get appbackup \
  -l testudo.softcdata.com/app-resource-owner-kind=datasync,\
testudo.softcdata.com/app-resource-owner-name=<datasync-name>

kubectl -n disaster-system get apprestore \
  -l testudo.softcdata.com/app-resource-owner-kind=datasync,\
testudo.softcdata.com/app-resource-owner-name=<datasync-name>
源集群查看 Velero Backup:
kubectl --context <source-cluster> -n velero get backup \
  -l testudo.softcdata.com/app-backup-name=ds-<datasync-name>

kubectl --context <source-cluster> -n velero get podvolumebackup
kubectl --context <source-cluster> -n velero get dataupload
目标集群查看 Velero Restore 和卷恢复:
kubectl --context <target-cluster> -n velero get restore
kubectl --context <target-cluster> -n velero get podvolumerestore
kubectl --context <target-cluster> -n velero get datadownload
kubectl --context <target-cluster> -A get pod -l trafficless=true
常见故障定位
| 现象 | 优先检查 |
|---|---|
DataSync 为 Failed,reason 是 StorageUnavailable | StorageRepository.status、源/目标集群 Velero BSL 是否 Available、对象存储网络和凭证 |
BackupFailed | 源集群 Velero Backup、PodVolumeBackup、DataUpload、源端 Pod 是否仍在运行 |
BuildRestoreSpecFailed | 实例恢复策略、StorageClass 映射、资源修改规则是否能编译和命中 |
RestoreFailed | 目标集群 Velero Restore、PodVolumeRestore、DataDownload、目标 StorageClass、provisioner 和 PVC 状态 |
目标端 PVC 一直 Pending | PVC 的 storageClassName 是否存在,目标集群 provisioner 是否正常,或者是否已提前准备满足容量、访问模式和 StorageClass 的静态 PV |
| 目标端临时 Pod 启动失败 | trafficlessConfig.image 是否可拉取、目标节点资源是否充足、镜像拉取 Secret 是否存在 |
| 同步成功但数据不是最新 | 是否跳过了 FinalSync、最近一次 lastSyncTime 是否符合 RPO、源端应用是否还有未刷盘数据 |
排障时不要只看 DataSync。需要沿着链路逐层看:
DataSync
  -> AppBackup
  -> source Velero Backup / PodVolumeBackup / DataUpload
  -> AppRestore
  -> target Velero Restore / PodVolumeRestore / DataDownload
  -> target PVC / trafficless Pod